

Obsidian CLI + Codex:把笔记库变成 Agent 的知识引擎
多数 AI 知识库从「先把全部资料上传」开始。Obsidian + Obsidian CLI 走的是另一条路:知识仍然是你硬盘上的 Markdown,Obsidian 负责链接、属性、任务和可视化,Codex 或其他 Agent 负责检索、综合和维护。
真正重要的变化发生在 2026 年 2 月 27 日。Obsidian 1.12 正式发布 Obsidian CLI,把搜索、读取、创建、重命名、反向链接、任务和属性等操作暴露给终端。官方甚至直接把「让 agentic tools 与你的 Vault 交互」列为用途。
这不是给笔记软件加一个聊天框,而是给本地知识库加了一层稳定的机器接口。
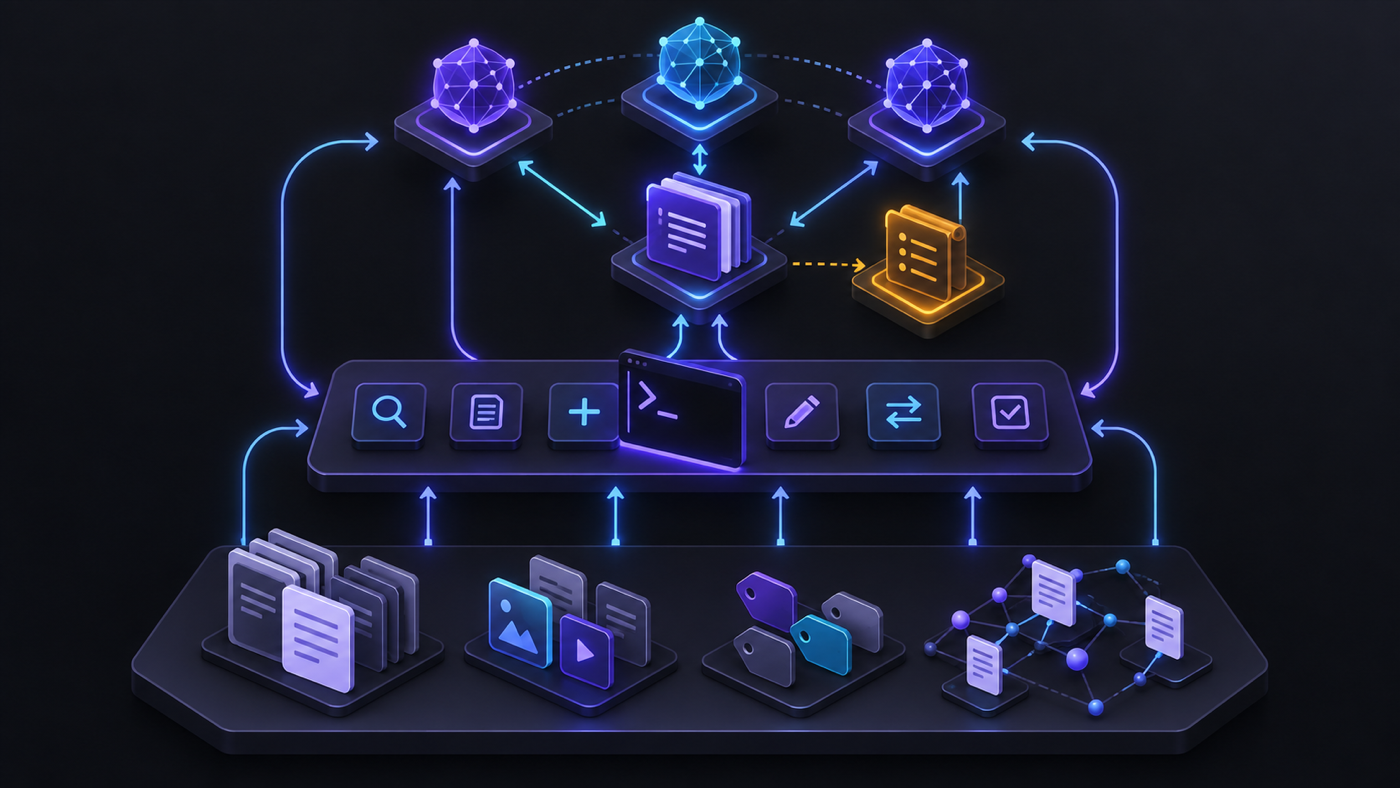
为什么它更像知识引擎,而不只是 AI 笔记插件
一个能长期工作的知识引擎,至少要有四层:
- 可迁移的记忆:Markdown、图片和附件都在普通文件夹里,不被某个模型或插件锁定。
- 结构化的索引:双链、标签、属性、任务、Bases 和目录让知识不只是全文文本。
- 可执行的接口:CLI 让 Agent 能用明确命令搜索、读取、创建和移动内容。
- 受约束的推理者:Codex、Claude Code、Gemini CLI、OpenCode 等 Agent 按规则工作,并留下操作日志。
过去 Agent 已经可以直接编辑 .md 文件,但它不知道 Obsidian 应用层的全部语义。直接用文件系统重命名一篇笔记,可能留下断链;obsidian rename 在 Vault 开启自动更新链接后会同步修正内部链接。直接 grep 能找字符串,obsidian backlinks、orphans、deadends 则能查询知识图谱的状态。
所以 CLI 的价值不是「终于能读 Markdown」。任何 Agent 早就会读。它真正补上的是:让 Agent 通过 Obsidian 自己理解的方式操作 Obsidian。
社区里已经发生的三个真实案例
这些是用户自述,不是独立基准测试;但它们很清楚地显示出工作流正在往哪里走。
事件一:多 Agent 入口先于官方 CLI 出现
2025 年 10 月 3 日,一位开发者在 r/ObsidianMD 发布 Agent Client,让 Claude Code、Gemini CLI 等 Agent 直接出现在 Obsidian 侧栏。到 12 月的更新中,它已经加入模式与模型切换,并明确支持 Codex。
这件事证明需求并不是「再来一个会补全文字的插件」,而是:用户想在同一份 Vault 上自由更换 Agent,同时保留笔记作为共同记忆。
事件二:AI 会话开始反向沉淀成知识
2026 年 1 月 31 日,另一位开发者发布 Chat2MD。它把分散在 Claude Code、Gemini CLI 和 Codex CLI 中的 JSON/JSONL 会话转换成 Markdown,写入日期、项目、会话 ID 和工作目录等 frontmatter,再通过每日笔记的反向链接进入 Obsidian。
这一步非常关键:Agent 不再只是消费知识库,它的工作过程也能回流、被搜索、被复盘。
事件三:第二大脑被拆成可维护的层
2026 年 7 月 15 日,r/ClaudeAI 上一篇 AI-maintained second brain 案例把 Vault 分为不可变的 Raw、快速收集的 Inbox、持续维护的 Wiki、索引和操作日志。作者用两类重复命令工作:ingest 负责保存来源并更新相关页面,query 先读索引,再只打开必要笔记,并附带引用回答。
它揭示了一个比「让 AI 搜全部笔记」更成熟的设计:原始证据、整理后的知识和 Agent 行为必须分开。
一个可以直接照抄的 Vault 结构
Second Brain/
├── AGENTS.md
├── Inbox/
├── Raw/                 # 原文与原始记录,只追加,不改写
├── Wiki/
│   ├── Concepts/        # 概念页
│   ├── Entities/        # 人、公司、项目
│   └── Decisions/       # 决策与依据
├── Projects/
├── Daily/
├── Index/
│   └── HOME.md
└── Ops/
    └── agent-log.md
Raw 是证据层,Wiki 是经过综合的认知层,Index 是低成本导航层,Ops 是审计层。最重要的规则是:Agent 可以修订 Wiki,但不能悄悄改写 Raw。
如果使用 Codex CLI,可以在 Vault 根目录放一个 AGENTS.md:
# Vault working rules

- Search Index/HOME.md before scanning the whole vault.
- Treat Raw/ as immutable evidence. Never rewrite or delete it.
- Every synthesized claim must link to at least one note in Raw/.
- Prefer obsidian rename/move over filesystem mv so links stay valid.
- Log every batch change in Ops/agent-log.md.
- Show the proposed file list before changing more than five notes.
Codex 官方文档说明,CLI 会在任务开始前读取作用域内的 AGENTS.md。Claude Code 或 Gemini CLI 可以用各自的指令文件表达同样规则;不要把关键治理逻辑只藏在一次性提示词里。
从零开始:15 分钟搭出第一个工作流
1. 开启 Obsidian CLI
按照 Obsidian CLI 官方说明,安装 1.12.7 或更新的桌面安装器,在 Settings → General 中开启 Command line interface,并注册到 PATH。CLI 连接正在运行的 Obsidian;它不是默认的无界面服务器。
先验证:
obsidian version
obsidian vault="Second Brain" files total
obsidian vault="Second Brain" search query="decision"
如果终端当前目录就在 Vault 中,可以省略 vault=。
2. 让 Agent 先检索,再读取
不要一上来把几千篇笔记全部塞进上下文。先让 Agent 查询索引和路径:
obsidian search:context query="pricing decision" path="Wiki" format=json
obsidian backlinks file="Pricing Strategy" format=json
obsidian read path="Wiki/Decisions/Pricing Strategy.md"
这形成一个简单却有效的检索漏斗:索引 → 搜索结果 → 相关笔记 → 原始证据。很多个人 Vault 不需要先搭向量数据库,词法搜索、链接图和良好标题就已经能覆盖大量问题。
3. 给 Codex 一个有验收条件的任务
在 Vault 根目录启动 codex,然后输入:
整理 Inbox/2026-09-22-agent-notes.md。

先读取 AGENTS.md 和 Index/HOME.md;用 Obsidian CLI 查找相关概念与反向链接。
把原文复制到 Raw/2026/,不要改写;在 Wiki/Concepts/ 更新或创建概念页;
每个新结论都链接到 Raw 来源;最后更新 Index/HOME.md,
并把文件清单、理由和未解决问题追加到 Ops/agent-log.md。

验收:不产生未解析链接;不覆盖 Raw 文件;改动前后分别报告 orphans 和 unresolved 数量。
这里最有用的不是模型名字,而是验收条件。Agent 知道什么叫完成,你也能用下面的命令验证:
obsidian unresolved total
obsidian orphans total
obsidian tasks todo verbose
4. 把一次成功操作变成可重复命令
成熟以后,可以把工作流做成 Agent skill 或脚本,而不是继续复制长提示词。例如:
/ingest <path>:保存原文、提取元数据、更新 Wiki、记录日志。/query <question>:先读索引,限制打开文件数量,回答时附路径引用。/weekly-review:汇总未完成任务、孤立笔记、断链和本周决策。/handoff <project>:生成项目状态、最近决策、风险与下一步,供另一个 Agent 接手。
Obsidian CLI 还支持 base:query 的 JSON/CSV 输出、tasks、properties、tags、diff 等命令,这些结构化输出比让模型解析整个界面稳定得多。
CLI、插件和直接读文件,应该怎么分工
三者不是互斥关系。
| 方式 | 最适合 | 局限 |
|---|---|---|
| 直接读写 Markdown | 批量文本处理、Git diff、跨平台自动化 | 容易绕过链接更新和 Obsidian 应用语义 |
| Obsidian CLI | 搜索、反链、属性、任务、Bases、链接安全的移动与重命名 | 需要桌面 Obsidian;必须管理写权限 |
| Obsidian 内插件 / ACP 客户端 | 获取当前打开文件、选区和低摩擦对话 | 增加插件供应链和 UI 依赖 |
2026 年 3 月 20 日的一场 Reddit 讨论 正好讲清了边界:CLI 负责打开、搜索、重命名和自动更新链接;插件负责持续告诉 Agent 当前打开了哪篇笔记、选中了哪段文字。它们是互补关系。
我的建议是:文件系统做底座,CLI 做标准执行面,插件只负责实时上下文和交互体验。 这样换掉任何一个 Agent 或插件,知识库都还在。
风险:本地文件不等于本地推理
这套架构很容易被误写成「完全私密」。这不准确。
Vault 存在本地,只能说明数据的主副本在你手里。Codex、Claude Code 或其他云模型在处理笔记时,相关内容仍可能被发送到对应服务。你需要检查所用产品、账户和组织的数据政策,而不是因为文件扩展名是 .md 就默认不会离机。
至少做四件事:
- 给 Agent 最小可用目录,不要默认授权整个硬盘。
- 把身份证件、密钥、医疗和客户机密排除在可读范围外。
- 对批量修改启用审批、Git 快照或 Obsidian File Recovery。
- 把外部网页和 Raw 内容视为不可信输入,防止其中的提示注入指挥 Agent 执行命令。
Codex 提供 sandbox、可写根目录和审批策略;这些边界应当是工作流的一部分,而不是出事后的补丁。
真正的护城河不是模型,而是可继承的上下文
今天你可以用 Codex,明天换 Claude Code,后天用 Gemini CLI。只要知识、规则、来源和操作日志仍是普通文件,新 Agent 就能接手。
这正是 Obsidian + CLI 最有价值的地方:它没有把第二大脑交给某个模型,而是把模型变成可替换的维护者。
最小可行版本不需要向量数据库,也不需要复杂 MCP。先做一个结构清楚的 Vault,写下治理规则,让 Agent 通过 CLI 完成一次带来源、带日志、可回滚的整理任务。等词法搜索真的不够,再加 embedding 或本地索引。
先把知识变成可维护的系统,再让 AI 变聪明。顺序反过来,得到的通常只是一个更会制造笔记的聊天框。
参考资料
评论
还没有评论。成为第一个评论的人!
相关工具


相关文章

我把 Obsidian 接入 OpenClaw 后,它开始帮我做决策
当 Obsidian 不再只是记笔记,而是接入 OpenClaw 之后,它开始帮我整理信息、连接上下文、推动判断,甚至参与真实决策。

Grok Bot、Hermes Bot:一个人,终于配上了智囊团和秘书处
Grok Bot 进了 Cursor Pro+,Hermes Bot 能跑在 VPS 上。它们不是更聪明的聊天框。出主意的是智囊团,抓落实的是秘书处,拍板的还是你。

Claude Code 的下一站,不是代码,而是你本地的 Obsidian 知识库
探索 Obsidian + Claude Code 如何从知识管理工具转变为你的私密 AI 助手。包含 obsidian-skills、Claudian 插件、Claudesidian 模板的完整指南,以及数据隐私与 AI 能力兼得的最佳实践。
