

deepseek-vl-7b-base
DeepSeek-VL-7B-Base は DeepSeek のオープンソース視覚言語モデルで、Hugging Face で deepseek-ai/deepseek-vl-7b-base として公開されています。モデルカードは「実世界の視覚と言語の理解アプリケーション向けに設計」と説明しています。7B パラメータのベースモデルでチャットモデルではなく、DeepSeek-VL シリーズに属し、関連論文は 2024 年 3 月のものです。2026 年 10 月 29 日時点でリポジトリは公開されたままで、ダウンロードできます。
主な機能
- 混合ビジョンエンコーダ:SigLIP-L と SAM-B を組み合わせ、1024 x 1024 の画像を入力できます。
- 言語バックボーン:DeepSeek-LLM-7B-Base。約 2 兆のテキストトークンで学習。カードによると、モデル全体はその後約 4,000 億の視覚言語トークンで学習されました。
- ベースのチェックポイント:事前学習版です。カードには同シリーズに別のチャット版があると記載されています。
- ライセンス:コードは MIT ライセンス、モデルの重みは DeepSeek Model License で、カードは商用利用に対応すると述べています。導入前にライセンス本文を確認してください。
- 形式:7B パラメータ、F16 Safetensors。
使用シナリオ
- 画像理解と画像に基づく言語モデリングの研究。
- 自分のデータで小型の視覚言語モデルをファインチューニングする出発点。
- 1 枚の GPU で画像とテキストのパイプラインを試作する。
制約:カードにコンテキスト長の記載はなく、ホスト提供もありません。2026 年 10 月 29 日時点で Hugging Face の推論プロバイダーは提供しておらず、自分で動かす必要があります。
料金プラン
重みは Hugging Face から無料でダウンロードできます。公式のホスト価格はありません。DeepSeek の現行 API モデルは DeepSeek V4 Flash と DeepSeek V4 Pro を参照してください。
はじめに
- モデルカードに記載の DeepSeek-VL の GitHub リポジトリをクローンし(Python 3.8 以上)、
pip install -e .を実行する。 VLChatProcessorとMultiModalityCausalLMでモデルを読み込み、画像とテキストの会話で推論する。カードのcli_chat.pyも使えます。- カードには、より短い Transformers の読み込み例もあります。
よくある質問
DeepSeek-VL-7B-Base は商用利用が無料ですか?
カードによると、DeepSeek-VL シリーズは DeepSeek Model License の下で商用利用に対応し、コードは MIT です。出荷前にライセンスを確認してください。
ベースの言語モデルは?
DeepSeek-LLM-7B-Base です。
対応する画像サイズは?
SigLIP-L と SAM-B の混合エンコーダにより 1024 x 1024 です。
より新しい DeepSeek の視覚モデルはありますか?
このカタログには DeepSeek V4 Flash Vision Exp があります。こちらは別の、より新しいラインです。
代替案
- DeepSeek V4 Flash:DeepSeek の現行の小型ホストモデル。
- DeepSeek V4 Flash Vision Exp:より新しい実験的な視覚エントリ。
- DeepSeek V4 Pro:現行のより大きなモデル。
まとめ
DeepSeek-VL-7B-Base は小型でライセンスが開かれた視覚言語のベースモデルで、研究やファインチューニングに役立ちます。ホスト型の本番利用には DeepSeek の新しいモデルを検討してください。ほかのモデルはモデルカテゴリをご覧ください。
コメント
まだコメントがありません。最初のコメントを投稿してください!
関連ツール

cogvlm-base-490-hf は Z.ai(旧 THUDM)が公開するオープンな CogVLM-17B の視覚言語モデルで、ビジュアルエキスパートを備え、コードは Apache-2.0 です。

関連インサイト

magpie で Codex を任意のモデルに向ける
magpie を入れ、ローカルまたはサインイン済みのプロバイダーを追加し、Codex をそのモデルに切り替える。2026-10-06 に公式ドキュメントを再確認。
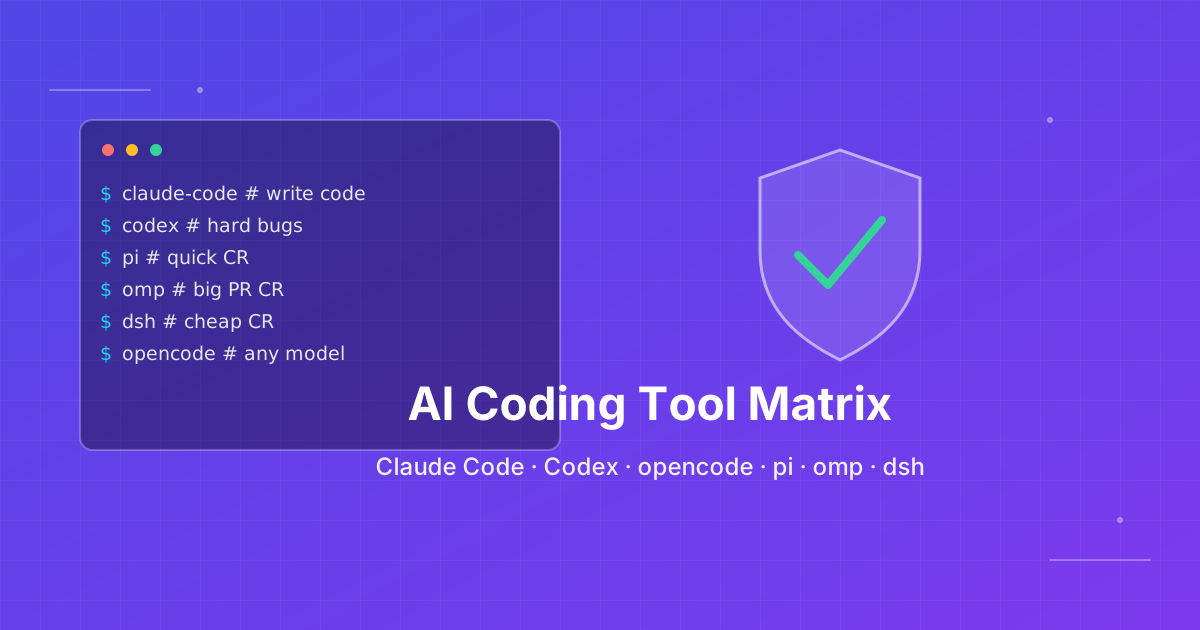
リポジトリの作業で AI コーディング CLI を選ぶ
Claude Code、Codex CLI、OpenCode、Pi、omp、DeepSeek Harness、Grok Build を、実際に回す作業に合わせて選ぶ。2026-10-06 に公式ドキュメントを再確認。
ChatGPT の Codex 枠が足りない?Codex 内で DeepSeek や Grok に切り替える
Codex Router なら、いつもの Codex 作業環境で DeepSeek や Grok などを使える。仕組み、利用枠、ネットワーク条件をやさしく説明する。