

Obsidian CLI + Codex:VaultをAgentの知識エンジンに変える
多くのAI知識ベースは「まず全資料をアップロードする」ところから始まります。ObsidianとObsidian CLIは別の道を選びます。知識は手元のMarkdownとして残し、Obsidianがリンク、プロパティ、タスク、ビューを管理し、CodexなどのAgentが検索、統合、保守を担当します。
決定的な変化は2026年2月27日に起きました。Obsidian 1.12で Obsidian CLI が正式公開され、検索、読み取り、作成、名前変更、バックリンク、タスク、プロパティといった操作がターミナルから使えるようになりました。公式ページも「agentic toolsからVaultを操作する」ことを用途として明記しています。
これはノートアプリにチャット欄を追加する話ではありません。ローカル知識ベースに、安定した機械向けインターフェースを追加する話です。
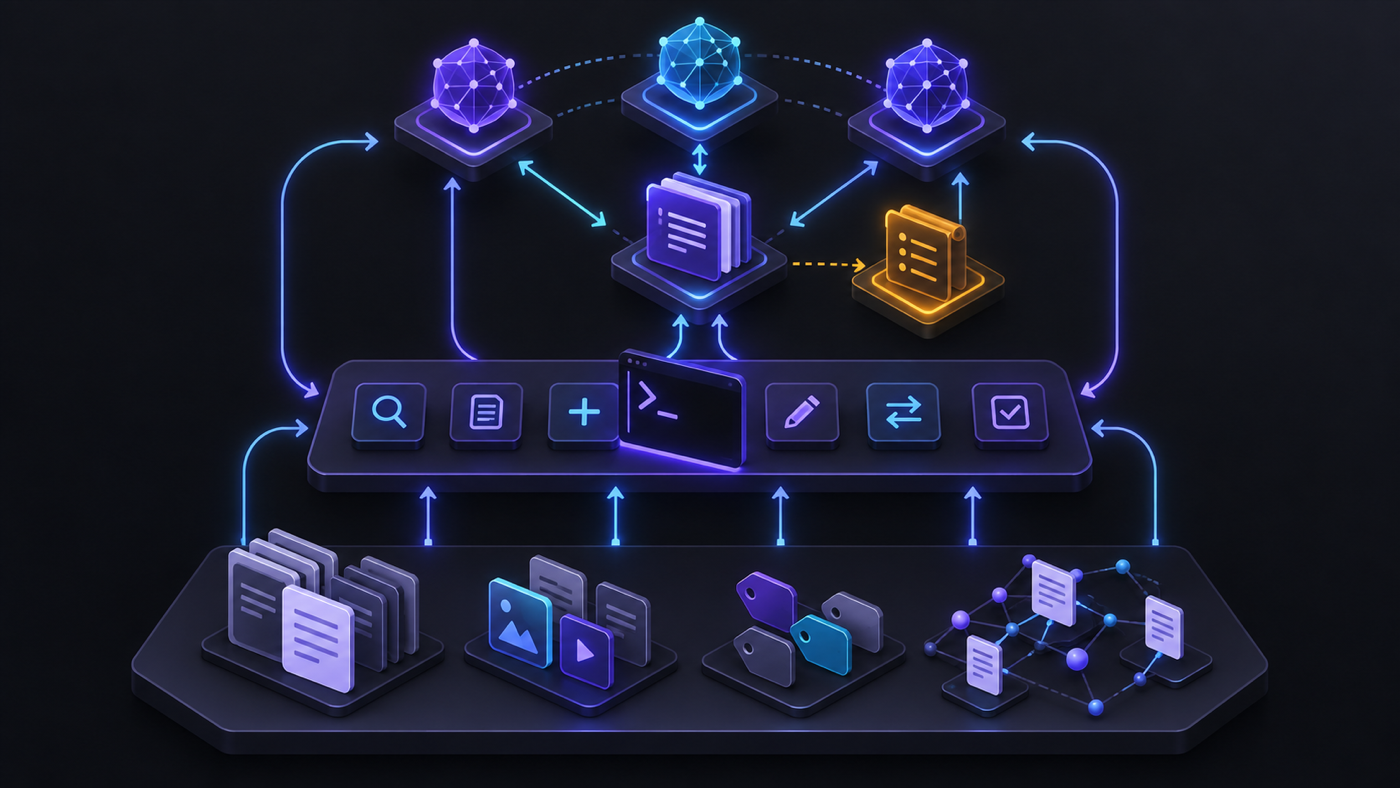
なぜAIノートプラグインではなく「知識エンジン」なのか
長く使える知識エンジンには、少なくとも4つの層が必要です。
- 移行可能な記憶:Markdown、画像、添付ファイルを通常のフォルダに置き、特定のモデルやプラグインに閉じ込めない。
- 構造化された索引:リンク、タグ、プロパティ、タスク、Bases、フォルダで全文以上の構造を持たせる。
- 実行可能なインターフェース:CLIで検索、読み取り、作成、移動を明示的なコマンドにする。
- 制約された推論者:Codex、Claude Code、Gemini CLI、OpenCodeなどがルールに従い、操作ログを残す。
Agentは以前から .md を編集できました。しかしファイルシステム上の編集は、Obsidianのアプリケーション意味論をすべて守るとは限りません。一般的なファイルコマンドでノート名を変えるとリンク切れが残る場合があります。Vaultでリンク自動更新を有効にしていれば、obsidian rename は内部リンクも更新できます。grep は文字列を探しますが、obsidian backlinks、orphans、deadends は知識グラフの状態を調べられます。
CLIの価値は「AgentがMarkdownを読めるようになった」ことではありません。それは以前から可能でした。本当の価値は、Obsidian自身が理解する方法でAgentがObsidianを操作できることです。
方向性を示す3つの実例
以下はユーザーの自己報告であり、独立したベンチマークではありません。それでも、ワークフローがどこへ向かっているかをよく示しています。
事例1:公式CLIより先にマルチAgentの入口が登場
2025年10月3日、ある開発者がr/ObsidianMDで Agent Client を公開し、Claude CodeやGemini CLIなどをObsidianのサイドバーから使えるようにしました。12月の更新ではモードとモデルの切り替えが追加され、Codex対応も明記されました。
求められていたのは、単なる文章補完プラグインではありません。同じVaultを共通記憶として保ちながら、Agentを自由に交換することでした。
事例2:AIとの会話がVaultへ戻り始めた
2026年1月31日、別の開発者が Chat2MD を公開しました。Claude Code、Gemini CLI、Codex CLIに分散しているJSON/JSONLセッションをMarkdownへ変換し、日付、プロジェクト、セッションID、作業ディレクトリをfrontmatterへ記録し、Daily Noteのバックリンクにつなげます。
これは重要な逆流です。Agentは知識ベースを消費するだけでなく、その作業過程も検索・再利用・振り返りが可能な知識として戻せます。
事例3:セカンドブレインが保守可能な層に分解された
2026年7月15日、r/ClaudeAIに投稿された AI-maintained second brain の事例では、Vaultを改変しない Raw、素早く保存する Inbox、継続的に保守する Wiki、索引、操作ログに分けています。ingest は情報源を保存して関連ページを更新し、query は先に索引を読み、必要なノートだけを開き、引用付きで回答します。
これは「AIに全ノートを検索させる」より成熟した設計です。原証拠、統合済み知識、Agentの行動を分離する必要があります。
そのまま使えるVault構成
Second Brain/
├── AGENTS.md
├── Inbox/
├── Raw/                 # 原文。追記のみで改変しない
├── Wiki/
│   ├── Concepts/
│   ├── Entities/
│   └── Decisions/
├── Projects/
├── Daily/
├── Index/
│   └── HOME.md
└── Ops/
    └── agent-log.md
Raw は証拠層、Wiki は統合した知識層、Index は低コストのナビゲーション層、Ops は監査層です。重要な原則は、AgentはWikiを改訂できても、Rawを黙って書き換えてはいけないことです。
Codex CLI を使うなら、Vaultのルートに AGENTS.md を置けます。
# Vault working rules

- Search Index/HOME.md before scanning the whole vault.
- Treat Raw/ as immutable evidence. Never rewrite or delete it.
- Every synthesized claim must link to at least one note in Raw/.
- Prefer obsidian rename/move over filesystem mv so links stay valid.
- Log every batch change in Ops/agent-log.md.
- Show the proposed file list before changing more than five notes.
Codexの公式ドキュメントによると、CLIは作業開始前にスコープ内の AGENTS.md を読みます。Claude CodeやGemini CLIでも、それぞれの指示ファイルで同等のルールを表現できます。重要なガバナンスを一度きりのプロンプトだけに隠さないでください。
15分で最初のワークフローを作る
1. Obsidian CLIを有効にする
Obsidian CLI公式手順 に従い、デスクトップ版1.12.7以降のインストーラーを使用し、Settings → GeneralでCommand line interfaceを有効化して PATH に登録します。CLIは実行中のObsidianアプリへ接続します。標準状態ではヘッドレスサーバーではありません。
まず確認します。
obsidian version
obsidian vault="Second Brain" files total
obsidian vault="Second Brain" search query="decision"
ターミナルのカレントディレクトリがVault内なら、vault= は省略できます。
2. Agentには読む前に検索させる
数千件のノートを最初からコンテキストへ入れないでください。先に索引とパスを絞ります。
obsidian search:context query="pricing decision" path="Wiki" format=json
obsidian backlinks file="Pricing Strategy" format=json
obsidian read path="Wiki/Decisions/Pricing Strategy.md"
これで 索引 → 検索結果 → 関連ノート → 原証拠 という単純で効果的な検索ファネルができます。個人Vaultの多くは、初日からベクトルデータベースを必要としません。字句検索、リンクグラフ、適切なタイトルだけで多くの質問を処理できます。
3. Codexに受け入れ条件付きのタスクを渡す
Vaultのルートで codex を起動し、次のように入力します。
Process Inbox/2026-09-22-agent-notes.md.

Read AGENTS.md and Index/HOME.md first. Use Obsidian CLI to find related concepts
and backlinks. Copy the source into Raw/2026/ without rewriting it. Update or create
concept pages in Wiki/Concepts/. Link every new claim to a Raw source. Finally update
Index/HOME.md and append the file list, rationale, and unresolved questions to
Ops/agent-log.md.

Acceptance: create no unresolved links; never overwrite a Raw file; report orphan and
unresolved counts before and after the change.
ここで重要なのはモデル名より受け入れ条件です。完了の定義が明確になり、次のコマンドで検証できます。
obsidian unresolved total
obsidian orphans total
obsidian tasks todo verbose
4. 成功した操作を繰り返し可能なコマンドにする
ワークフローが安定したら、長いプロンプトを毎回貼るのではなく、Agent skillやスクリプトにします。
/ingest <path>:原文を保存し、メタデータを抽出し、Wikiを更新してログを残す。/query <question>:索引から読み始め、開くファイル数を制限し、ノートパスを引用する。/weekly-review:未完了タスク、孤立ノート、リンク切れ、今週の決定をまとめる。/handoff <project>:別のAgent向けに状態、最近の決定、リスク、次の行動を生成する。
Obsidian CLIには base:query のJSON/CSV出力、tasks、properties、tags、diff もあります。Agentに画面全体を解析させるより、構造化出力の方が安定します。
CLI、プラグイン、ファイル直接操作の役割分担
3つは競合せず、補完関係にあります。
| 方法 | 最適な用途 | 制約 |
|---|---|---|
| Markdownの直接操作 | 一括テキスト処理、Git diff、クロスプラットフォーム自動化 | リンク更新やObsidianの意味論を迂回しやすい |
| Obsidian CLI | 検索、バックリンク、プロパティ、タスク、Bases、リンクを保つ移動と名前変更 | デスクトップObsidianが必要で、書き込み権限の管理も必要 |
| Obsidianプラグイン / ACPクライアント | 開いているファイル、選択範囲、低摩擦な対話 | プラグインのサプライチェーンとUIへの依存が増える |
2026年3月20日の Redditでの議論 は境界をうまく説明しています。CLIはファイルを開く、検索する、名前を変える、リンクを自動更新するといった操作を担当します。プラグインは、現在どのノートを開き、どの文字列を選択しているかをAgentへ継続的に伝えます。両者は補完関係です。
おすすめは、ファイルシステムを基盤、CLIを標準実行面、プラグインをリアルタイム文脈と操作体験の層にすることです。Agentやプラグインを交換しても、知識は残ります。
注意点:ローカルファイルはローカル推論を意味しない
この構成は「完全にプライベート」と説明されがちですが、その表現は正確ではありません。
Vaultがローカルにあるとは、データの主要コピーを自分で管理できるという意味です。Codex、Claude Code、その他のクラウドモデルがノートを処理する場合、関連内容が各サービスへ送信される可能性があります。使用する製品、アカウント、組織のデータポリシーを確認してください。拡張子が .md だから端末外へ出ない、とは限りません。
最低でも次を実行してください。
- Agentにディスク全体ではなく、必要最小限のディレクトリだけを渡す。
- 身分証、認証情報、医療情報、顧客機密を読み取り範囲から外す。
- 一括変更には承認、Gitチェックポイント、Obsidian File Recoveryを使う。
- WebページとRawノートを信頼できない入力として扱い、プロンプトインジェクションからコマンド実行を守る。
Codexにはsandbox、書き込み可能ルート、承認ポリシーがあります。これらの境界は事故後の対策ではなく、ワークフローの一部にすべきです。
持続的な強みはモデルではなく、引き継げる文脈
今日はCodex、明日はClaude Code、来週はGemini CLIを使えます。知識、ルール、情報源、操作ログが通常のファイルである限り、新しいAgentへ引き継げます。
これがObsidianとCLIの最大の価値です。セカンドブレインを一つのモデルへ渡すのではなく、モデルを交換可能な保守担当者にします。
最小構成にベクトルデータベースや複雑なMCPは不要です。まず構造の明確なVaultを作り、ガバナンスルールを書き、CLI経由で出典付き、ログ付き、ロールバック可能な保守タスクを一度完了させます。字句検索が本当に足りなくなったときに、embeddingやローカル索引を追加すれば十分です。
先に保守可能な知識システムを作り、その後でAIを賢くする。順序を逆にすると、増えるのは知識ではなく、ノートを量産するチャット欄になりがちです。
参考資料
コメント
まだコメントがありません。最初のコメントを投稿してください!
関連ツール


関連記事

Grok Bot と Hermes Bot:一人に、ようやく参謀本部と事務局がつく
Grok Bot は Cursor Pro+ に入った。Hermes Bot は VPS で走る。より賢いチャット窓ではない。助言するのは参謀本部、実行するのは事務局、決裁するのはあなただ。

Obsidian を OpenClaw に接続したら、意思決定まで手伝い始めた
Obsidian がただのノート置き場ではなく OpenClaw とつながったとき、情報整理、文脈接続、判断材料の整理、そして実際の意思決定支援まで始まった。

7 つの AI コーディング CLI を半年使って悟ったこと:モデルがどんなに強くても、仕事には監督が必要
Claude Code、Codex、opencode、pi、omp、DeepSeek Harness はそれぞれ性格が違う。半年間の深い使用で確立した分業:pi で最速最省のレビュー、omp で複雑な PR レビュー、DeepSeek Harness + V4 Flash で高頻度・低コストなレビュー、Claude Code と Qoder でコーディング。モデルがどんなに強くても、仕事には監督が必要——しかも独立した第三者であるべき。
