
DeepInfer
DeepInfer 是 DeepSeek 发布的 Apache-2.0 离线推理框架,用于在大规模集群上运行推理服务。首个公开版本仅支持 DeepSeek V4.1 Flash,目标硬件为 NVIDIA SM100 GPU 或华为 Ascend 950 NPU。它不是托管的 DeepSeek API,也不是通用模型启动器;团队仍需准备兼容硬件、Linux 环境、模型存储,以及引擎外部的服务组件。
核心能力
- 面向服务的执行路径: 已包含优化内核、模型与采样器运行时、异步调度、数据/上下文/专家并行和专家负载均衡。
- 受约束的输出: 文档中的采样器可用正则、JSON Schema 或 EBNF grammar 约束生成,适合需要机器可读结果的服务。
- 可重复请求: NVIDIA 部署可启用批次不变推理和固定序列种子的确定性采样,便于排查服务变更,但应权衡吞吐影响。
- 离线起步: 官方仓库给出源码构建与
examples/offline_inference.py;默认通过 Hugging Face 缓存下载 DeepSeek V4.1 Flash 权重。
实用工作流
先在隔离的 Linux 主机上准备 Python 3.12、GCC 13+ 和官方 README 指定的加速器环境:NVIDIA 用 CUDA 13,Ascend 用 CANN 9.2。设置匹配的 DEEPINFER_ACCELERATOR 后从源码构建;若下载受限,可用 DEEPINFER_HF_MODEL_DIR 指向预先审核的本地权重。先运行离线示例,再接入 API 网关。随后用真实请求测试结构化输出 schema、固定种子的行为与失败恢复。
已经运行 DeepSeek V4 Flash 且希望评估 DeepSeek 自维护服务引擎的团队可关注它。需要单 GPU 且支持范围明确的本地运行时,可比较 NInfer;模型或硬件超出官方支持范围时,应使用更通用的运行器。
限制与成本
项目目前只写明 NVIDIA SM100 与 Ascend 950,要求 Linux 和源码构建,并未承诺消费级 GPU、任意 Hugging Face 模型或托管端点。README 也说明,完整服务仍需要 KV 缓存系统、Prefill/Decode 解耦,以及数据并行副本之间的负载均衡。其性能图由 DeepSeek 在 4 张 SM100 做 prefill、64 张做 decode 测得,应视为厂商测试,不可直接作为其他集群的容量规划。
软件采用 Apache-2.0,但硬件、电力、存储、网络、模型访问与运维人员均为额外成本。上线前应先完成受限的非生产压测。
评论
还没有评论。成为第一个评论的人!
相关工具


相关洞察
GPT-6 Astra 没追上 Fable 5.1,追上的是账单
Artificial Analysis 智能指数上 Fable 5.1 66 分、Astra 61 分,Astra 没追上智力。但完成同一批任务的成本只要 Fable 5.1 的不到一半,真正收紧的是账单,不是脑子。
用 magpie 把 Codex 接到任意模型
安装 magpie,加入本地或已登录的供应商,再把 Codex 切到该模型。2026-10-06 对照 magpie 官方文档复核。
按仓库任务选 AI 编程 CLI
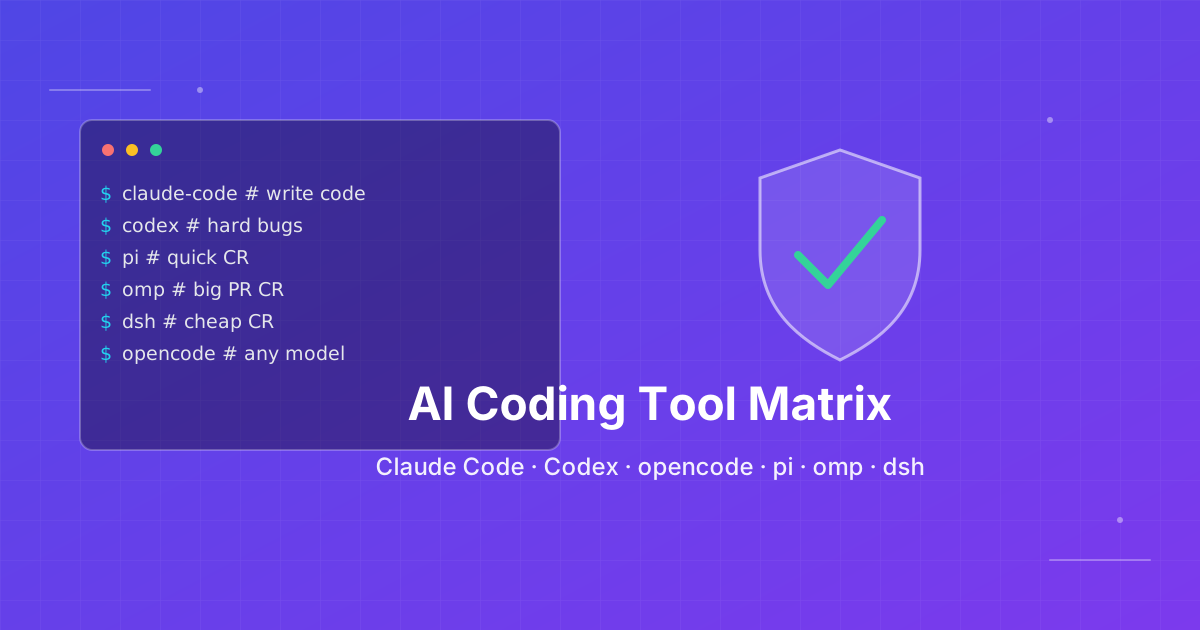
按你真正要跑的工作,在 Claude Code、Codex CLI、OpenCode、Pi、omp、DeepSeek Harness 与 Grok Build 之间选择。2026-10-06 对照官方文档复核。