

cogvlm-base-490-hf
cogvlm-base-490-hf 是 CogVLM 在 Hugging Face 上的一个检查点。CogVLM 是一个开源视觉语言模型,可以就图像与用户对话。其模型卡现托管在 zai-org(Z.ai)组织下,项目最初由清华大学的 THUDM 发布。模型卡没有解释名称中“490”的含义,因此本条目不去猜测输入分辨率。
模型规格
| 规格 | cogvlm-base-490-hf |
|---|---|
| 发布方 | Z.ai(zai-org),最初为 THUDM |
| 类型 | 视觉语言模型,输入图像加文本,输出文本 |
| 规模 | CogVLM-17B:约 100 亿视觉参数和 70 亿语言参数;Hugging Face 页面显示 BF16 下为 18B |
| 组成 | 视觉 Transformer 编码器、MLP 适配器、预训练语言模型、视觉专家模块 |
| 代码许可证 | Apache-2.0 |
| 权重许可证 | 单独的 Model License,见模型卡说明 |
| 论文 | CogVLM: Visual Expert for Pretrained Language Models |
核心功能
- 视觉专家设计:根据模型卡,模型在预训练语言模型中加入视觉专家模块,而不只是外挂一个视觉编码器。
- 图像对话与 VQA:模型卡描述了围绕图像的多模态对话,以及图像描述和视觉问答等任务,并提供输入图像和文本查询的 Transformers 快速上手示例。
- 厂商基准声明:作者称在 10 个跨模态基准上取得最先进结果,并在 VQAv2、TextVQA 等多个基准上位居第二。这些是作者自己的声明,不是独立测评。
适用场景
- 研究视觉专家架构和开源视觉语言基线。
- 复现或对比 CogVLM 论文的结果。
- 需要自托管权重的图像问答与图像描述本地实验。
需要注意:这是较早的开源视觉语言模型,已有更新的开源视觉语言模型;模型卡中也提到权重使用单独的许可证,商用前请先阅读 Model License。
快速开始
- 阅读模型卡和 CogVLM 的 GitHub 仓库,仓库包含代码、论文和许可证文件。
- 按模型卡中的示例,用 Hugging Face Transformers 加载模型。
- 准备大显存 GPU:同系列的 cogvlm-chat-hf 模型卡说明推理约需 40GB 显存,或借助 accelerate 拆分到多块较小的 GPU。请以 base-490 模型卡的说明为准。
- 在依赖它之前,先用你自己的图片测试。
常见问题
cogvlm-base-490-hf 是什么?
Hugging Face 上的开源 CogVLM 视觉语言模型检查点,来自现在署名为 Z.ai 的团队。
它有多大?
模型卡给出 CogVLM-17B 的 100 亿视觉参数和 70 亿语言参数,Hugging Face 页面显示 BF16 下为 18B 参数。
用什么许可证?
仓库代码为 Apache-2.0,模型权重适用单独的 Model License。
名称里的 490 是什么意思?
模型卡没有说明,因此从官方页面无法确定。
替代方案
- LLaVA 1.6 34B:支持动态高分辨率输入的 LLaVA-NeXT。
- Qwen-VL:阿里巴巴的视觉语言系列。
- Llama 3.2 Vision:Meta 的多模态 Llama 版本。
- DeepSeek-VL 7B:较小的开源视觉语言基础模型。
总结
cogvlm-base-490-hf 适合作为 CogVLM 视觉专家方案的开源、有文档的参考。想从官方角度了解它是什么、如何授权,请从 Hugging Face 模型卡开始,更多视觉模型见模型分类。
评论
还没有评论。成为第一个评论的人!
相关工具


相关洞察
GPT-6 Astra 没追上 Fable 5.1,追上的是账单
Artificial Analysis 智能指数上 Fable 5.1 66 分、Astra 61 分,Astra 没追上智力。但完成同一批任务的成本只要 Fable 5.1 的不到一半,真正收紧的是账单,不是脑子。
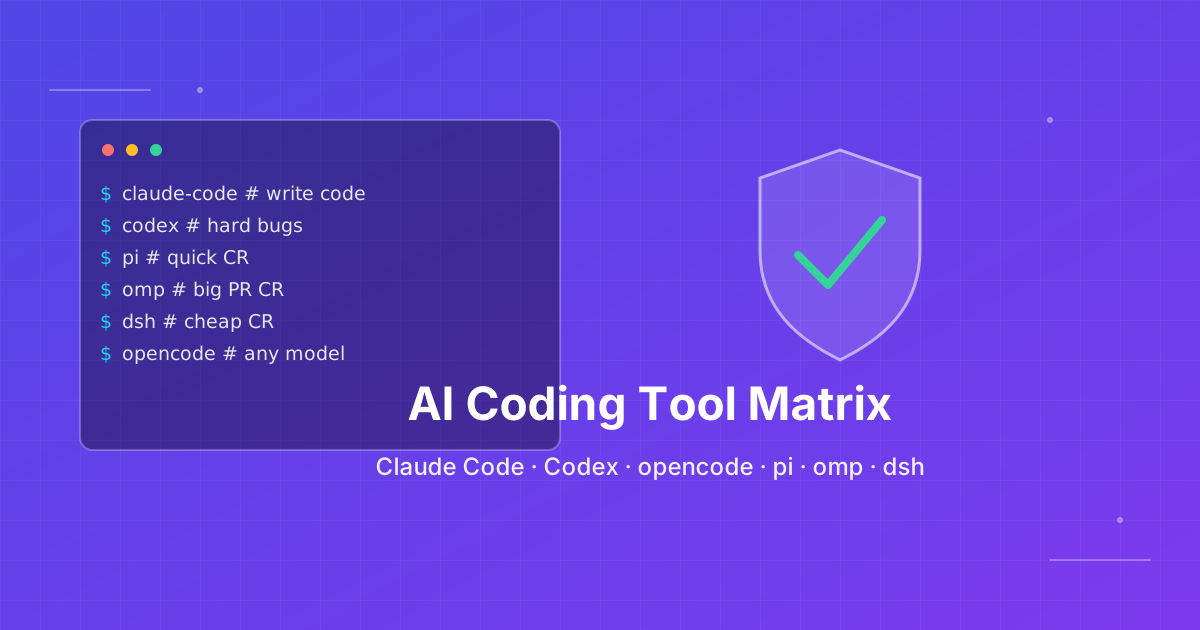
按仓库任务选 AI 编程 CLI
按你真正要跑的工作,在 Claude Code、Codex CLI、OpenCode、Pi、omp、DeepSeek Harness 与 Grok Build 之间选择。2026-10-06 对照官方文档复核。
ChatGPT 额度不够用?在 Codex 里切换 DeepSeek 和 Grok
Codex Router 让你继续使用熟悉的 Codex 工作台,同时把任务交给 DeepSeek、Grok 等外部模型。看懂它怎样工作、额度怎么算,以及“不用翻墙”的前提。