
2026 年 AI 模型怎么比
这里的模型页是产品卡片,不是我们编的榜单。写代码和智能体仍是 GPT 与 Claude。Gemini 是 Google 体系默认。Grok 是 xAI。DeepSeek 是真正会被人私有化部署的开源权重。打开词条看现行模型 ID 和厂商价目,不要把目录简介当成评测。
写代码用哪个模型?
每个季度都会变。去 Claude、GPT、Gemini 的官网,再用你自己的仓库跑一遍。本页不冻结排行榜。
开源权重还是 API?
API 简单。DeepSeek、Llama、Qwen、Gemma 适合要自己跑的场景。成本是机器和运维,不是一张 $20 订阅。
价格在哪看?
只看厂商。OpenAI、Anthropic、Google、xAI、DeepSeek 各自公布。我们给链接,不编造 token 单价。
2026 年 AI 模型怎么比全部工具(共 223 款)
点击查看每款工具的详情、功能与定价。
 Agnes-3.0-FlashAgnes-3.0-Flash Preview 是 Apache-2.0 的 33B 多模态开源权重,上下文 262k,…
 Claude 3.5 SonnetClaude 3.5 Sonnet 是 Anthropic 2024 年 6 月发布的 200K 上下文模型,已于 20…
- Claude 3 HaikuClaude 3 Haiku(claude-3-haiku-20240307)是 Anthropic 2024 年 3…
- Claude 3 OpusClaude 3 Opus(claude-3-opus-20240229)是 Anthropic 已退役的模型:2025…
- Claude 3 SonnetClaude 3 Sonnet(claude-3-sonnet-20240229)已于 2025 年 7 月 21 日从…
- Claude Opus 4.5Anthropic 上一档 Opus 快照:20 万上下文,每百万 token $5/$25。更晚在售的线包括 Opus…
- Claude Sonnet 4.5Anthropic 上一档 Sonnet 快照:20 万上下文,每百万 token $3/$15。文档现主推更新的 Cl…
- Claude v1Claude v1 是 Anthropic 第一代 API 模型(claude-1.0 至 claude-1.3),已于…
 LensVLM-9B苹果发布的 9B 视觉语言模型:把文档当作压缩图片来读,只把真正相关的页面放大还原,在 4.3 倍压缩下仍保持全文级别的…
 AREX-2北京智源研究院的 27B 开源权重智能体模型(Apache-2.0),在编码、机器学习工程与深度研究任务中按提出、度量、…
 Bespoke NimbleBespoke Labs 开源的 9B 权重模型与完整训练配方,把 Jev 式的判定变成带概率的单 token 选择,可…
 BGE-M3BGE-M3 是智源(BAAI)的开源多语言嵌入模型:MIT 许可,1024 维向量、8192 token 输入,同时支…
 BAAI bge-reranker-v2.5-gemma2-lightweightBAAI bge-reranker-v2.5-gemma2-lightweight 是基于 Gemma 2 9B 的约…
 Breeze TTS 2BreezeBlue 开源的双语语音合成模型,专为实时交互而生。支持免参考音色的语音设计、参考引导的音色指挥,冷启动首音…
- Claude Fable 5.1Anthropic 公开发布的 Fable 级模型,面向编程与知识工作。输入/输出 $10/$50 /百万 token,…
- Claude Fable 5Anthropic 首个向公众开放的 Mythos 级旗舰模型:1M token 上下文、前沿编程与视觉能力、长达数天的…
- Claude Haiku 4.5Claude Haiku 4.5 是 Anthropic 2025 年 10 月发布的小型模型:每百万 token $1…
- Claude Haiku 5.5Anthropic 于 2026 年 10 月 7 日发布的小型 Claude 模型,面向高吞吐、低成本任务,适合分类、…
- Claude Mythos 5.1Anthropic 面向网络安全与生命科学的最强模型,需受邀可信访问。与 Claude Fable 5.1 同一引擎,但…
- Claude Opus 4.6Anthropic 最强混合推理模型:100 万 token 上下文、自适应思考,在智能体编码与专业知识工作上位居行业前…
- Claude Opus 5.5Anthropic Claude Opus 5.5:Fable 5.1 级智能,每 1M token $4/$20,1M…
- Claude Opus 5Anthropic 前沿 Opus 级模型,1M token 上下文与可调思考强度,以 Opus 4.8 的价格带来接近…
- Claude Sonnet 5.5Anthropic Claude Sonnet 5.5:Claude 5.5 家族第二款模型,价格与 Sonnet 5…
- Claude Sonnet 5Claude Sonnet 5 是 Anthropic 于 2026 年 6 月 30 日发布的旧版中档模型,每百万 t…
 cogvlm-base-490-hfcogvlm-base-490-hf 是 Z.ai(原 THUDM)发布的开源 CogVLM-17B 视觉语言模型检查点…
 Cohere Command A+Command A+ 是 Cohere 首个混合专家旗舰:218B 总参数、25B 激活参数,支持 48 种语言与图像输…
- Cohere: Command ACohere Command A 是 111B 参数的企业级模型,上下文 256K,支持 23 种语言,擅长工具调用、R…
- Cohere: Command RCohere Command R 是面向 RAG 与工具调用的 35B、128K 上下文模型;command-r 别名(…
- Cohere Embed v3Cohere Embed v3 包含四个文本与图像嵌入模型,分英文和多语言两类,维度为 1024 与 384,输入上限…
- Cohere Rerank 3.5Cohere Rerank 3.5(rerank-v3.5)发布于 2024 年 12 月 2 日,上下文 4k,支持多…
 OpenAI: dall-e-2DALL-E 2(dall-e-2)是 OpenAI 支持局部重绘的文生图模型;OpenAI 模型页面称它已被弃用并从…
- OpenAI: dall-e-3OpenAI 2023 年 11 月的图像模型,现已弃用并从 API 移除。官方要求新项目改用 GPT Image 2。
 Deepgram Nova-2上一代 Deepgram 语音识别(ASR)模型,官方文档现在优先推荐 Nova-3 与 Flux,不应再被当作 202…
 DeepSeek-Coder-V2.5DeepSeek 从未发布过名为 Coder-V2.5 的模型;2024 年 9 月的 DeepSeek-V2.5 合并…
- DeepSeek-R1DeepSeek-R1 是 6710 亿参数(每 token 激活 370 亿)的推理模型,基于强化学习训练,2025…
- DeepSeek V2.5DeepSeek-V2.5 于 2024 年 9 月 5 日发布,把 DeepSeek-V2-Chat 与 Coder-…
- DeepSeek V3DeepSeek V3 是 671B 参数的混合专家模型(每 token 激活 37B),训练数据 14.8T toke…
- DeepSeek-V4.1-FlashDeepSeek-V4.1-Flash 是 MIT 的 552B 多模态 MoE,预填充 8B、解码 16B 激活,1M…
 DeepSeek-V4-Flash-Vision-ExpDeepSeek-V4-Flash-Vision-Exp 是 V4 家族首个多模态实验:Flash 架构加视觉模块,MI…
- DeepSeek V4 FlashDeepSeek 官方小型智能体模型:284B 总参 / 13B 激活 MoE 架构、1M token 上下文、MIT…
- DeepSeek V4 Pro 0813DeepSeek 旗舰 1.6T MoE 模型,激活参数 49B,1M token 上下文,MIT 协议开源权重,Liv…
- DeepSeek V4DeepSeek V4 预计将是 DeepSeek 旗舰模型系列的下一个重大版本,继备受赞誉的 V3 和 V3.2 之后…
- deepseek-vl-7b-baseDeepSeek-VL-7B-Base 是开源的 7B 视觉语言模型,采用 SigLIP-L 与 SAM-B 混合视觉编…
 DFlash 2Inco AI 的 Apache 2.0 块扩散推测解码草稿模型。2026-08-18 发布,覆盖 Qwen3.8-27…
 Dream-1Dream Labs 的机器人控制世界行动模型 API:提交兼容双臂平行夹爪机器人的观测并请求动作,厂商称可用于未见过的…
 ElevenLabs Turbo v2.5ElevenLabs Turbo v2.5(eleven_turbo_v2_5)是已弃用的低延迟语音合成模型,支持 32…
 EmbeddingGemmaGoogle DeepMind 的轻量级多语言文本嵌入模型,专为设备端 AI 优化,内存占用小于 200MB。Embed…
 Ember-1Fireworks Research 把 Kimi K3 改造成「想得更少」的版本:基准分数基本不变而 token 少约…
 Flux.1 DevBlack Forest Labs 2024 年 8 月发布的 Flux.1 Dev 开源权重图像模型,现已是上一代,当…
- Flux.1 Pro上一代 BFL 图像 SKU。活目录是 FLUX 3 和 FLUX.2。不是 2024 年压过 Midjourney/D…
 FLUX 3Black Forest Labs 多模态模型,覆盖视频、音频、即将推出的图像与动作预测,支持最长 20 秒片段、原生音…
 Gemini 2.0 Flash ThinkingGemini 2.0 Flash Thinking 是 Google 的实验性推理模型,2024 年 12 月发布,并计…
- Gemma 4 26B A4BGoogle DeepMind 开源权重模型,25.2B 总参数 MoE 架构每 token 仅激活 3.8B,256K…
 GLM-4.7智谱 AI 推出的开源多语言多模态对话模型,具有先进的思考能力、卓越的编码性能和增强的 UI 生成能力。GLM-4.7…
- GLM-5.2智谱 2026 年 6 月的 744B MoE 编程模型,1M 上下文、MIT 权重。现行旗舰已是后继的 GLM-5.3…
- GLM-5.3-Flash智谱首个原生多模态 GLM 系列模型(即此前匿名的 'Ox Alpha'):320B MoE、仅 18B 激活、1M 上…
- GLM-5.3智谱的 GLM-5.3 编程模型,通过 GLM Coding Plan 使用,推理始终开启,上下文 1M、最大输出 12…
- Google: Gemini 1.5 Flash-8BGemini 1.5 Flash-8B 是 Google 体量更小、更便宜的 Gemini 1.5 Flash 变体,2…
- Google: Gemini 2.0 FlashGemini 2.0 Flash 已于 2026 年 6 月 1 日在 Gemini API 中停服。它支持多模态输入、…
- Google: Gemini 3.1 Flash-LiteGemini 3.1 Flash-Lite(gemini-3.1-flash-lite)是 Google 的稳定版模型,…
- Google: Gemini 3.1 Flash LiveGemini 3.1 Flash Live(gemini-3.1-flash-live-preview)是旧版音频到音频…
- Google: Gemini 3.1 Flash TTSGemini 3.1 Flash TTS(gemini-3.1-flash-tts-preview)是 Google 旧…
- Google: Gemini 3.1 ProGemini 3.1 Pro Preview(gemini-3.1-pro-preview)是 Google 2026…
- Google: Gemini 3.5 Flash-LiteGemini 3.5 Flash-Lite(模型 ID gemini-3.5-flash-lite)是 Google 的…
- Google: Gemini 3.5 FlashGoogle 以行动为导向的前沿模型:为智能体与编码而生,支持 100 万 token 上下文,以 Flash 级别的速…
- Google: Gemini 3.5 Live TranslateGemini 3.5 Live Translate(gemini-3.5-live-translate-preview)…
- Google: Gemini 3.6 FlashGemini 3.6 Flash(gemini-3.6-flash)是 Google 稳定版的上一代 Flash 模型,…
- Google: Gemini 3.7 FlashGoogle 面向智能体工作流与多模态推理的最强 Flash 模型:100 万 token 上下文、6.5 万输出 to…
- Google: Gemini 3.8 Flash TTSGemini 3.8 Flash TTS 能用一句话设计全新音色、30 秒样本复刻嗓音,并以 71.4 分拿下 Hume…
- Google: Gemini 3 FlashGoogle 最新前沿模型,以前所未有的速度和成本效益提供突破性智能。Google: Gemini 3 Flash 收录…
- Google: Gemini 3 ProGemini 3 Pro Preview(gemini-3-pro-preview)发布于 2025 年 11 月 18…
- Google: Gemini 4 ArgonGoogle 新一代前沿模型:面向长时程编程、企业知识工作与网络防御,输出上限提升至 100 万 token,并经由 F…
- Google:Gemini 4 CarbonGoogle 的 Gemini 4 Carbon 是面向长时程工程与网络防御的前沿模型,首批仅向受信任的防御者开放。
- Google: Gemini Flash 1.5Gemini 1.5 Flash(gemini-1.5-flash)是 Google 2024 年发布的快速多模态 Ge…
- Google: Gemini Nano Banana 2 LiteNano Banana 2 Lite(gemini-3.1-flash-lite-image)是 Google 最快最便…
- Google: Gemini Omni FlashGemini Omni Flash(gemini-omni-1.1-flash)是 Google 的视频生成与编辑模型,…
- Google: Gemini Pro 1.5Gemini 1.5 Pro 于 2024 年 2 月 15 日发布,是混合专家架构的多模态模型,上下文最高 100 万…
- Google: Gemma 2 27BGemma 2 27B 是 Google 的 27B 开放权重纯解码器文本模型,训练数据 13T token,提供预训练…
- Google: Gemma 2 9BGemma 2 9B 是 Google 于 2024 年 6 月 27 日发布的 9B 开放权重文本模型,训练数据 8T…
- GPT-5.6 LunaOpenAI GPT-5.6 Luna(gpt-5.6-luna)是面向大批量任务的低成本模型,上下文 105 万 to…
- GPT-5.6 TerraOpenAI GPT-5.6 Terra:5.6 家族均衡日常主力,40 万上下文,每 100 万 tokens 输入…
- GPT-5.2OpenAI 上一世代前沿模型:40 万上下文、12.8 万最大输出,每百万 token $1.75/$14。文档现推荐…
- GPT-5.6 SolOpenAI 前沿旗舰:1,050K token 上下文、最高 max 档推理强度与 ultra 子智能体模式,Term…
- GPT-6.1 SolOpenAI GPT-6.1 Sol:面向编程、电脑操作和专业工作的近 Astra 级智能,标准 API 价格为 GPT…
- GPT-6.1 TerraOpenAI 于 2026 年 10 月 26 日发布的 GPT-6.1 Terra,面向视觉推理、计算机操作、编程和高…
- GPT-6 AstraOpenAI 旗舰 GPT-6 Astra:105 万 token 上下文,电脑操作与编程达新高,API 每 1M to…
- GPT-6 LunaOpenAI GPT-6 Luna:GPT-6 系列最便宜的档位,每 1M token $0.10/$0.50,105…
- GPT-6 SolOpenAI GPT-6 Sol:105 万 token 上下文、推理强度可拉到 max,每 1M token $2/$…
 GPT Image 2OpenAI 最新图像生成模型,面向快速、高质量的生成与编辑,支持灵活尺寸至 4K,并按 token 计费的官方 API…
 IBM Granite 4.2 30BIBM 的开源权重稠密推理大模型:30B 参数、Apache 2.0、原生 128K 上下文可扩至 512K,内置思维链…
 Grok 4.6SpaceXAI(原 xAI)的前沿 1.5T 推理模型,具备 50 万 token 上下文、出色的智能体编码能力与实时…
- Grok 4.7SpaceXAI 的 Grok 4.7 旗舰,面向编码与智能体:50 万 token 上下文,$1.60/$4.80 每…
- GrokxAI / SpaceXAI 的 Grok 家族。当前文档旗舰是 grok-4.6:50 万上下文、$2/$6 每百万…
 Hy4 preview腾讯新一代开源权重 MoE 旗舰:总计 770B、每 token 激活 49B,1M 上下文,Apache 2.0。采用…
 Ideogram 2.0Ideogram 2.0 于 2024 年 8 月 21 日发布,是 Ideogram 的文生图模型,对所有用户免费;I…
 Index-Translate哔哩哔哩开源的多语言翻译模型家族:覆盖 150 种语言文本、语音字幕、受控配音与长文档翻译,基于 Qwen3.5 构建。
 JevJev 是 TypeSafe 的 System One 模型,输出带校准概率的类型化决策,输入价为每百万 token 0…
 Jina Embeddings v4Jina Embeddings v4 是 40 亿参数的多模态多语言嵌入模型,支持文本、图像和视觉文档,上下文 32K,…
- Jina AI Reranker v3Jina Reranker v3 是基于 Qwen3-0.6B 的 0.6B 参数 listwise 多语言重排序模型,…
 K2-Horizon-7BK2-Horizon-7B 是 IFM 推出的开放权重语言模型,提供 512K 上下文、工具调用与分阶段训练检查点,适合…
 KAT-Coder V2.5Kwaipilot 开源智能体编程模型:35B MoE、每 token 激活 3B,基于 Qwen3.6 基座,Apac…
 Kimi K3月之暗面(Moonshot AI)开源的 2.8T 参数多模态智能体模型,1M token 上下文,全球首个开源 3T…
 Kolibri-1Aleph Alpha 发布的德英双语开放权重推理模型,总参数约 78B、每 token 激活约 3.46B,支持工具调…
 Laguna S 2.1Poolside 开源权重编程模型:118B 总参 / 8B 激活 MoE、100 万 token 上下文、原生交错推理…
 LFM 2.5-2.6BLiquid AI 专为端侧智能体负载训练的 2.6B 开源权重稠密模型,支持 128K 上下文与原生工具调用。LFM…
 LFM2.5-24B-A2BLiquid AI 面向本地智能体的开放权重 240 亿参数推理 MoE 模型,含 24.5 亿激活参数、128K 上下…
 LFM3-1.7BLiquid AI 面向本地智能体、工具调用、结构化输出和领域微调的 17.3 亿参数开放权重文本模型,支持 256K…
 Ling-3.0-flash-VLLing-3.0-flash-VL 是 inclusionAI 的 MIT 多模态 MoE:总参 124B,激活 5.5…
 Ling-3.0-flashinclusionAI 的 MIT 混合线性 MoE:总参 124B,激活 5.1B。2026-08-21 在 Hugg…
 Ling-3.0-tinyLing-3.0-tiny 是 inclusionAI 的 MIT 混合线性 MoE:总参 7.9B,激活 1.3B,面…
- Liquid d1-3BLiquid AI 的 3B 多模态决策模型,基座为 LFM2.5-VL-3B,面向校准分类、文档分类与政策标签等边缘端…
 Llama 3.1 Euryale 70B v2.2Euryale v2.2 是 Sao10K 基于 Llama 3.1 70B 的角色扮演与创意写作微调模型,在 8 张…
- Llama 3 Euryale 70B v2.1Llama 3 Euryale 70B v2.1 是 Sao10K 基于 Llama 3 的 70B 角色扮演向 LoR…
 LLaMA Guard 3Llama Guard 3 是 Meta 基于 Llama 3.1 的安全分类模型,可在 14 个危害类别、8 种语言下…
- llava-v1.6-34b-hfllava-v1.6-34b-hf 是 LLaVA-NeXT 34B 的 Hugging Face Transforme…
 LongCat 2.0美团开源 MoE 大模型:总参数 1.6T / 激活约 48B,1M 上下文,MIT 协议,擅长编码与智能体任务(202…
 Mercury 2.5Inception 的扩散语言模型:260K 上下文,并行生成 1,107 tokens/s,首发期输入仅 $0.04/…
 Mercury 2Inception 的扩散推理模型:128K 上下文、并行生成约每秒 1000 token,输入价格每百万 token…
- CodeLlama 34B InstructCode Llama 34B Instruct 是 Meta 的 340 亿参数指令微调代码模型,支持代码补全、填充与代…
- Llama 3.1 405B InstructLlama 3.1 405B Instruct 是 Meta 于 2024 年 7 月 23 日发布的开源权重对话模型:…
- Llama 3.1 70B InstructMeta Llama 3.1 70B Instruct 于 2024 年 7 月 23 日发布,是 70B 开放权重对话…
- Llama 3.1 8B InstructLlama 3.1 8B Instruct 是 Meta 于 2024 年 7 月 23 日发布的 8B 指令微调模型,…
- Llama 3.2 1B InstructLlama 3.2 1B Instruct 是 Meta 的 12.3 亿参数多语言文本模型,上下文 128k,2024…
- Meta Llama 3.2 Vision2024 年 Llama 3.2 视觉模型(11B / 90B)快照,llama.com 现在主推 Llama 4,因此…
- Llama 3 70B InstructMeta Llama 3 70B Instruct 于 2024 年 4 月 18 日发布,是 70B 开放权重对话模型…
- Llama 3 8B InstructLlama 3 8B Instruct 是 Meta 于 2024 年 4 月 18 日发布的 80 亿参数指令微调聊天…
- Llama v2 70B ChatLlama 2 70B Chat 是 Meta 2023 年 7 月发布的开放权重对话模型:70B 参数、4K 上下文、…
 Midjourney V6Midjourney V6 于 2023 年 12 月 20 日发布,2024 年 2 月 14 日至 7 月 30 日…
 MiMo-V2.6小米 MiMo-V2.6 开源权重系列:旗舰 Pro 为 1.02T 总参数、42B 激活的稀疏 MoE,另有 309B…
 mini-AGImini-AGI 是一个字节级模型,在 8GB 显存显卡上从零开始训练,并能持续从单一数据流中学习而不遗忘已掌握的内容。
 MiniCPM5-2B面壁智能 MiniCPM5-2B 是 2B 端侧稠密模型,131k 上下文、Apache-2.0 开源,面向本地助手与工…
 MiniMax H3MiniMax 于 2026 年 7 月 31 日发布的开源向多模态视频模型:文/图/视频/音频输入,768P 或 2K…
 MiniMax M2.1开源的 230B 参数 MoE 模型,专为多语言编程、智能体工作流和真实世界开发任务优化,SWE-bench 性能达到…
 MiniMax M3.1 FlashMiniMax 于 2026 年 10 月 19 日推出的 API 模型,面向编程、智能体工作流与计算机使用,统一 to…
- MiniMax M3MiniMax 2026 年 6 月 1 日的开源向旗舰模型:MSA 架构、100 万 token 上下文、原生图像/视…
- MiniMax-Music3MiniMax 第三代开源权重音乐生成模型:录音棚级音质与无数码杂音的自然人声,凭提示词和歌词生成完整歌曲,官方支持 C…
 Mistral Large 4Mistral Large 4 是面向编程、推理和自托管 Agent 工作负载的开放权重多模态 MoE 模型。
- Mistral: Mistral 7B InstructMistral 7B Instruct 是 Mistral 7.3B Apache 2.0 模型的指令微调版本;Mist…
- Mistral: Mistral NemoMistral Nemo 12B(open-mistral-nemo-2407)是与 NVIDIA 合作的 Apache…
- Mistral Nemo Inferor 12BMN-12B-Inferor-v0.0 是 Infermatic AI 发布的社区 12B 融合模型,用 mergeki…
- Mistral OCR 4.1Mistral OCR 4.1 是 Mistral 于 2026 年 7 月 16 日正式发布的文档 OCR 服务,支持…
- Mistral Pixtral 12B2024 年 Mistral 12B 视觉快照。活目录是 Medium 3.5 / Small 4 / Large 3。…
- Mistral Shieldstral 1.0Mistral Shieldstral 1.0 是面向文本与图像的紧凑型多模态安全分类模型,基于 Ministral 3…
- Mistral SmallMistral Small v24.09(mistral-small-2409)是 22B、32k 上下文的模型,Mis…
- Mistral TinyMistral Tiny 是 Mistral 7B 的 API 名称,2024 年 2 月更名为 open-mistra…
- Mistral Voxtral Mini Transcribe 2Mistral Voxtral Mini Transcribe 2(voxtral-mini-2602)是 2026 年…
- Mistral Voxtral Mini Transcribe RealtimeVoxtral Mini Transcribe Realtime 是 Mistral 的开放权重实时语音转文字模型(Ap…
- Mistral Voxtral TTSMistral Voxtral TTS(v26.03)是文本转语音模型,支持零样本声音克隆、9 种语言,首个音频约 90…
 Muse GlimmerMeta 开源 30B 智能体多模态模型:从 Muse Spark 蒸馏,专为本地常驻编码与工具调用智能体设计,单张消费…
- Muse Spark 1.2Meta 面向编码的旗舰模型,驱动 Muse Code 终端智能体:1M 上下文、更高的首试准确率、可靠的工具调用,通过…
 Muse Spark OpenMeta 面向代码与智能体的开放权重多模态 MoE,具备 8160 亿总参数、420 亿激活参数和 100 万 toke…
 mixedbread ai mxbai-rerank-large-v1mxbai-rerank-large-v1 是 mixedbread ai 的 0.4B 英文重排序模型,Apache…
 MythoMax 13BMythoMax-L2-13b 是 Gryphe 基于 Llama 2 13B、合并 MythoLogic-L2 与 H…
 Nex-N2.5-miniNex-N2.5-mini 是 Nex-AGI 的 Apache-2.0 多模态智能体模型,面向计算机使用、浏览和编程。
 Nex-N2.5-ProNex-N2.5-Pro 是 Nex-AGI 的 Apache-2.0 多模态智能体检查点,面向计算机使用、浏览和编程。
 Nous: Hermes 3 405B InstructHermes 3 405B 是 Nous Research 对 Llama 3.1 405B 的全参数微调模型,支持函数…
- NousResearch: Hermes 2 Pro - Llama-3 8BHermes 2 Pro Llama-3 8B 是 NousResearch 基于 Llama 3 8B 微调的开放权重…
 NV-Embed-v22024 年 NVIDIA 嵌入模型快照,Hugging Face 模型卡仍在,许可、上下文与文件以该卡为准,不应再被当…
- NVIDIA nv-rerankqa-mistral-4b-v3NVIDIA nv-rerankqa-mistral-4b-v3 是 2024 年面向问答的重排序模型,用于 NeMo…
- NVIDIA: Llama 3.1 Nemotron 70B InstructLlama 3.1 Nemotron 70B Instruct 是 NVIDIA 用 RLHF 调优的 Llama 3.…
- NVIDIA Nemotron 3.5 Lightning 30B A3BNVIDIA 高效开源权重模型,30B 总参数仅激活 3B,MoE 混合架构,最长 1M token 上下文,单卡部署,…
- omni-moderation-latestomni-moderation-latest 是 OpenAI 免费的内容审核模型:通过 /v1/moderations…
- OpenAI: GPT-4o-miniGPT-4o mini(gpt-4o-mini-2024-07-18)上下文 128K,定价 0.15/0.60 美元;…
- OpenAI: GPT-4oGPT-4o(gpt-4o)是 OpenAI 的多模态模型,每百万 token $2.50/$10,128K 上下文;已…
- OpenAI: o1-miniOpenAI o1-mini(o1-mini-2024-09-12)曾是低成本推理模型,上下文 128k、最大输出 65…
- OpenAI: o1-previewOpenAI o1-preview(o1-preview-2024-09-12)已于 2025 年 7 月 28 日关停…
- Shap-eShap-E 是 OpenAI 开源的 MIT 许可研究模型,可根据文本或图像生成 3D 物体,方法见论文 arXiv…
 OpenChat 3.5 7BOpenChat 3.5 7B(0106)是基于 Mistral-7B-v0.1 微调的 Apache 2.0 对话模型…
 OrukeetOrukeet 是覆盖 25 种语言的语音识别模型,在 NVIDIA Parakeet TDT 0.6B v3 上冻结拟…
 Peacebell从零训练的英语二战主题小模型,提供 291M 与 148M 参数版本、Apache-2.0 权重及 CPU 演示,不具备…
 Qwen 4阿里下一代旗舰 Qwen 4 正在训练中,官方路线图显示 Qwen 4.5 与 Qwen 5 系列预计将扩展到 5 万亿…
- Qwen-Audio-3.1阿里 Qwen-Audio-3.1 语音栈新增 ASR-Next 与 TTS-Next,TTS 登顶 Artificia…
 Qwen-Drive-1.0-4BQwen-Drive-1.0-4B 是阿里 Apache-2.0 的驾驶视觉语言模型,把三维感知、VQA 和运动规划放在…
 Qwen-Image-2.1Qwen-Image-2.1 是阿里 7B 开放权重模型,同一套权重既做文生图也做图像编辑,还支持原生透明 PNG 与最…
- Qwen-VLQwen-VL 是阿里云 2023 年基于 Qwen-7B 的视觉语言模型,可输入图像、文本和边界框,输入分辨率 448…
- Qwen2.5 72B Instruct上一代 Qwen2.5 72B Instruct 快照,活旗舰已经是 Qwen3.8,因此不应再被当作 2026 年的最…
- Qwen2.5-72B阿里 2024 年 9 月的 Qwen2.5-72B 稠密大模型快照,活旗舰已经是 Qwen3.8,因此不应再被当作 2…
- Qwen2.5 Coder 32B Instruct上一代 Qwen2.5-Coder 32B Instruct 快照。活编码路径是 Qwen3.8 Coder。不是最新系…
- Qwen2.5-Coder-32BQwen2.5-Coder-32B 是阿里巴巴 2024 年 11 月发布的 Apache 2.0 代码基础模型,32.…
- Qwen2-VL 72B InstructQwen2-VL-72B-Instruct 是阿里的 72B 视觉语言模型,支持动态图像分辨率和 20 分钟以上视频理解…
- Qwen3.8-2.4T-A95B阿里巴巴旗舰 2.4T MoE 模型,激活参数 95B,1M token 上下文,原生多模态输入,PaperBench…
- Qwen3.8-27B阿里巴巴开源的 27B 稠密模型,Qwen3.8-Max 的配套稠密版本,Apache 2.0 协议,支持图文多模态输入…
- Qwen3.8-Flash-Next阿里通义千问公开的 Qwen4 架构预览:125B 多模态 MoE、每 token 仅激活 6B,外加 51B N-gr…
- Qwen3.8-Max阿里 2.4T 参数开源旗舰:95B 激活的 MoE,原生文本/图片/视频输入,1M 上下文,输入 $2 / 输出 $6…
- Qwen3.8-Omni-FlashQwen3.8-Omni-Flash 是阿里的全模态智能体模型:100 万 token 上下文,原生输入文本、图像、音频…
- Qwen3-EmbeddingQwen3-Embedding 是阿里巴巴 Qwen 的 Apache 2.0 文本嵌入系列(0.6B、4B、8B),3…
- Qwen3-VL-EmbeddingQwen3-VL-Embedding 是通义千问的 Apache-2.0 多模态嵌入系列(2B 与 8B),支持文本、图…
- Qwen3-VL-RerankerQwen3-VL-Reranker 是通义千问的 Apache 2.0 多模态重排序模型,提供 2B 和 8B 两种规模…
- QwQ-32B-PreviewQwQ-32B-Preview 是 Qwen 2024 年 11 月发布的实验性 32B 推理模型,基于 Qwen2.5…
 Realtime-VenusRealtime-Venus 是 Apache 2.0 的 9B 全双工音视频模型,能在继续听的同时说话、被打断、并委派…
 Recursive FlintRecursive 推出的 Apache-2.0 39.8B MoE 编程智能体模型,约 2.5B 参数激活,支持工具调…
 Reflection Beam 1.0Reflection AI 的 Apache-2.0 开放权重 501B MoE,面向编程与长程智能体任务,单 toke…
- rerank-english-v3.0rerank-english-v3.0 是 Cohere 的纯英文重排序模型,上下文长度 4k;Cohere 文档现已列…
- rerank-multilingual-v3.0Cohere rerank-multilingual-v3.0 是上下文 4k 的多语言重排序模型;Cohere 文档现…
- Cohere: rerank-v3.5Cohere rerank-v3.5 是 2024 年 12 月 2 日发布的多语言重排序模型,上下文 4k token…
 Rocinante 12BRocinante 12B 是 TheDrummer 面向角色扮演与冒险叙事的 120 亿参数微调模型,有 v1 和 v…
 sanoTTS超小神经网络 TTS,参数量 294k 到 2.3M。可在浏览器或约 3 美元的 ESP32-S3 上离线合成。11 个…
 Seedance 2.5ByteDance Seed 的音画联合生成模型,面向 30 秒叙事、更准的参考控制、可延长两次,并提供绿幕等专业剪辑能…
 Upstage: Solar Mini 4Upstage 的 35B 混合专家模型,仅 3B 激活参数,512K 上下文,输入 $0.10/百万 token,主打…
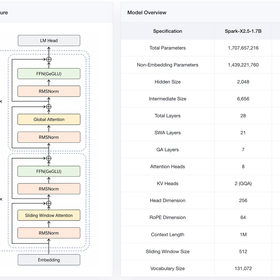 Spark-X2.5-4BXHToken 出品的精简开源权重模型:混合滑窗注意力实现原生 1M 上下文,编码与 Agent 表现出色,Apache…
 Stable Diffusion 3.5Stable Diffusion 3.5 是 2024 静帧家族。社区许可,不是完全 MIT。首页还主推音频和 Bran…
 StepAudio 3 GenStepAudio 3 Gen 是阶跃星辰的音频生成模型,可根据角色、台词和场景描述组合生成配音、音效、环境音与音乐,适…
 Supra2-IMGSupra2-IMG 是 Apache-2.0 许可的 104M 参数文生图 DiT,在一张 H100 上从零训练 9…
 Swift-Qwen3.8-27BSwift-Qwen3.8-27B 是 UkisAI 基于 Qwen3.8-27B 的高效推理微调,思考 token 约…
 Ternary Bonsai 2Ternary Bonsai 2 是 27B 的 Qwen3.8 三值 GGUF,模型卡称在 5.95 GB 包里保住…
- text-embedding-3-largetext-embedding-3-large 是 OpenAI 能力最强的嵌入模型:默认 3072 维、输入上限 819…
- text-embedding-3-smallOpenAI text-embedding-3-small 是嵌入模型,默认 1536 维,输入上限 8192 toke…
- text-embedding-ada-002上一代 OpenAI 文本嵌入模型 text-embedding-ada-002 的快照,价表仍列每百万 token $…
- text-moderation-latesttext-moderation-latest 是 OpenAI 的纯文本内容审核模型别名,已于 2025 年 10 月…
 Tiel-Coder 35B A3B基于 Ornith-1.5-35B-A3B 的社区智能体编码 MoE 模型,约 35B 总参数、每 token 激活 3…
- OpenAI: tts-1-hdOpenAI tts-1-hd 是质量优先的文本转语音模型,价格为每百万字符 $30;OpenAI 模型页面将其列为已弃…
- OpenAI: tts-1OpenAI 托管的 tts-1 文本转语音快照,价表仍列每百万字符 $15,偏重速度,不是本地开源权重,也不是 202…
 VonVon 是 Apache-2.0 的 395M System One 决策模型,在 Apple MPS 上约 18 毫秒…
 voyage-3-largevoyage-3-large 是 Voyage AI 于 2025 年 1 月最新发布的最先进通用和多语言 embedd…
 Voyage AI Rerank 2Voyage AI rerank-2 是第二代多语言重排序模型,上下文 16K token,现已列为较早的模型;Voya…
 WeLM-617B微信 AI 的 617B MoE 模型,每 token 激活 23B,通过 Hidden Decoding 首次在前沿规…
 WeMM-Embedding腾讯微信视觉团队推出的通用多模态嵌入模型家族(2B/4B/9B),基于 Qwen3.5。文本、图像、视频与视觉文档统一映…
- OpenAI: whisper-1OpenAI 托管的 whisper-1 语音转写快照,价表仍列每分钟 $0.006,不是本地开源权重,也不是 2026…
- Whisper V3Whisper large-v3 是 OpenAI 的开放权重语音识别与翻译模型,支持 99 种语言,使用 128 个梅…
 WizardLM-2 7BWizardLM-2 7B 是微软 WizardLM 团队基于 Mistral-7B-v0.1 微调的对话模型,Apac…
- WizardLM-2 8x22BWizardLM-2 8x22B 是 2024 年 4 月 15 日发布的三款开放 WizardLM-2 模型中最大的一…
- xAI: Grok BetaGrok Beta 是 xAI 首个 API 模型的临时名称,2024 年 11 月 4 日上线,上下文 128,000…
 YuE2-3BYuE2-3B 是 M·A·P 的 CC BY-NC 音乐模型,先写出可编辑乐谱,再渲染人声与伴奏,可在本地 24GB…