
llama-modchip 是面向希望把指定稀疏 MoE 权重放进本机 CPU 内存运行的开发者的 Apache-2.0 工具包,并不假定必须有大显存 GPU。其维护中的第一方资料是 Synchopate GitHub 仓库。项目 v2.4.0 于 2026-11-04 发布,文档列出了 Linux、macOS、Windows、x86_64、ARM64 和 CPU/GPU 混合路径。
它是针对本地推理的专用技术栈,不是通用模型目录或托管 API。项目提供内核补丁、GGUF 转码工具、modchip 命令行,以及面向部分 MoE 检查点的预构建运行路径。适合愿意自行核对硬件、存储、模型许可和输出质量的操作者。
核心能力
- CPU 优先的 MoE 推理:README 记录了用系统内存运行指定 DeepSeek V4 Flash 与 NVIDIA Nemotron 检查点的方式,也支持部分配置的 GPU 卸载。
- 统一命令行:
modchip提供 setup、chat、web、benchmark、eval、quantize、status 与 stop 等命令。 - 本地端点与 Agent 接入:项目文档给出本地聊天和服务工作流,并说明了把本地模型接入 Claude Code 类工具的一种路径。
- 先检查硬件:仓库包含在下载大型权重前检查 CPU 准备情况的脚本。
适用场景
如果你更关心本地控制、CPU-only 实验,或希望审慎部署 CPU/GPU 混合方案,llama-modchip 值得评估。它更适合已经理解 GGUF、模型许可证、内存预算和本地网络暴露风险的系统开发者。若要更广泛、上手更直接的本地运行器,可对比 Ollama;若目标是 Apple Silicon 专用服务,可对比 mlx-serve。
成本与边界
仓库为 Apache-2.0,未列订阅价格,但部署并非没有成本:权重、用电、存储和机器由操作者承担,各检查点也有独立许可与分发条款。项目列出的吞吐、内存和质量数字均为第一方基准声明,不能当作独立性能认证。
快速开始
- 阅读 README 与硬件说明,在非生产机器运行准备检查。
- 只选择文档明确支持的检查点,并核对其许可和下载大小。
- 先用本地 chat 或 benchmark 命令,不要一开始就公开服务端口。
- 用真实提示词验证质量、延迟和内存。任何编程 Agent 接入都应先隔离凭据和生产仓库,再人工审阅。
常见问题
它能让所有大模型都在小电脑上运行吗?
不能。文档只针对支持的架构与配置;内存、CPU 指令集、磁盘空间和模型格式仍决定是否可行。
文档里的性能数字有保证吗?
没有。它们是项目在注明配置上的自报测量,应作为自行压测的起点,而不是采购或容量承诺。
总结
llama-modchip 是面向 CPU 优先与混合本地 MoE 推理探索的可审查工具链。从官方 README开始,先验证模型许可和硬件适配,再决定是否用于重要工作流。
评论
还没有评论。成为第一个评论的人!
相关工具

DeepSeek 开源的 Apache-2.0 离线推理框架,面向 DeepSeek V4.1 Flash 在 NVIDIA SM100 GPU 或华为 Ascend 950 NPU 上的大规模服务。


相关洞察
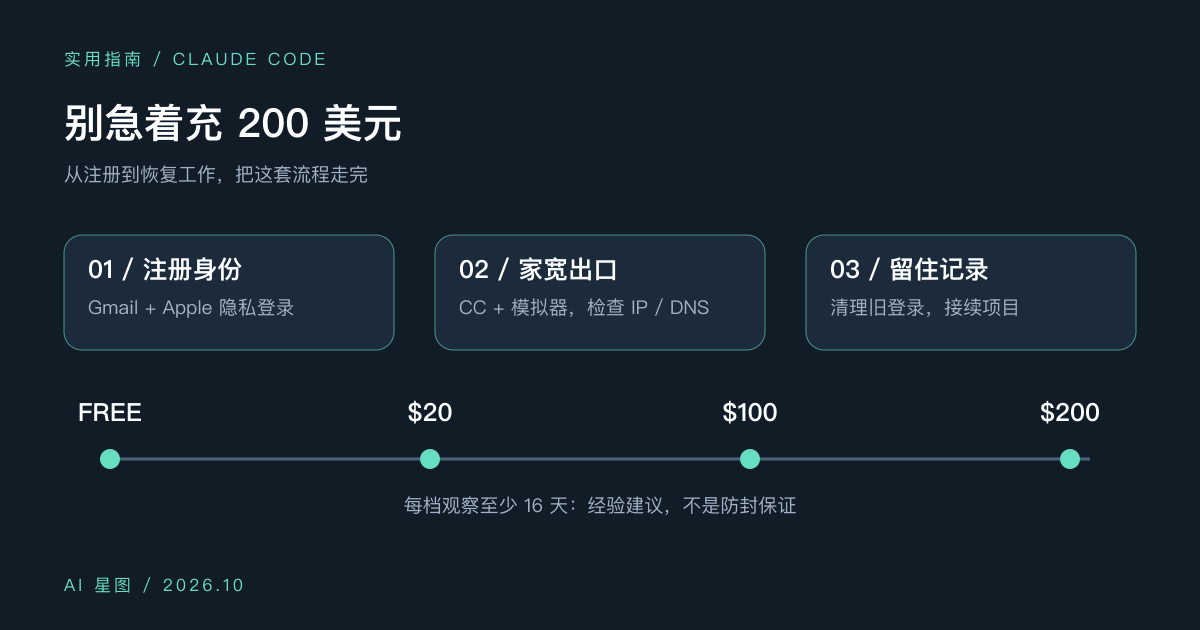
Claude Code 使用秘籍:别急着充 200 美元,先走完这套流程
Gmail 配 Apple 隐私登录,Clash Verge 接 Cliproxy 家宽,模拟器也查 IP 和 DNS。订阅每档隔半个月以上,账号出问题先保住 CC 记录。附配置和脚本。
GPT-6 Astra 没追上 Fable 5.1,追上的是账单
Artificial Analysis 智能指数上 Fable 5.1 66 分、Astra 61 分,Astra 没追上智力。但完成同一批任务的成本只要 Fable 5.1 的不到一半,真正收紧的是账单,不是脑子。
用 magpie 把 Codex 接到任意模型
安装 magpie,加入本地或已登录的供应商,再把 Codex 切到该模型。2026-10-06 对照 magpie 官方文档复核。