
Edge0 是一个 Apache-2.0 本地推理项目,可通过命令行、本地服务器或聊天应用运行其稀疏模型。项目于 2026 年 11 月 13 日发布 Edge0-145B 和 Edge0-120B:两款由 Qwen3.8-Flash-Next 衍生的 latent MoE 权重。该版本面向搭载受支持 NVIDIA GPU 与 CUDA 13 的 Linux 或 Windows 系统;最新权重并非面向 Mac 或手机的通用部署路径。
核心能力
- 大型本地权重:145B 与 120B 总参数检查点在 Hugging Face 提供 Q3_K 和 NVFP4 版本。项目称它们是面向本地编码和 Agent 工作负载、原生以 4 bit 训练的 latent MoE 模型。
- 统一本地接口:
edge0-infer提供chat与serve,项目同时提供兼容 OpenAI 的本地服务器说明。较早的 35B 模型通过原生引擎覆盖更多设备类别。 - 明确的硬件边界:当前 145B/120B 通过
edge0-strata运行在 Linux 或 Windows 的 NVIDIA CUDA 环境;不能因旧 35B 引擎的平台列表而推断最新模型支持 Apple Silicon。 - 本地处理选择:权重与服务可以留在自有硬件,避免将一次请求交给托管模型;但仍必须保护本地端点、模型文件、提示词和日志。
实用工作流
- 阅读官方模型说明,核对 CUDA 13 及列出的 GPU、内存要求。
- 下载官方 Hugging Face 的 145B 或 120B 变体,并安装匹配的 Edge0 发布包。
- 先用
edge0-infer chat做小范围编码或推理评估,只有应用确需 API 时再用edge0-infer serve。 - 将服务限制在可信网络接口,并在替换云模型前,用真实提示词测试质量、延迟、内存和许可义务。
限制与对比
项目公布的基准和吞吐量可作为起点,但均为项目方、特定硬件条件下的报告,而非独立保证。145B 不代表每台工作站都可运行:最新模型的 NVIDIA/CUDA 路径比旧 35B 引擎更窄。需要更广本地兼容性的团队可比较 Qwen3.8-Flash-Next 或选择更小的检查点;需要托管 API 的团队也不应把本地服务器等同于云服务的运维控制。
常见问题
Edge0 是否开源?
代码仓库采用 Apache-2.0。代码与权重的条款可能不同,下载或再分发前应核对每个模型卡和发布工件。
当前 145B 能在 macOS 上运行吗?
按项目 11 月 13 日的平台表不能。145B/120B 列为 Linux 或 Windows + NVIDIA GPU + CUDA 13;表中的 macOS 支持属于旧 35B 原生引擎路径。
为什么不用托管模型?
当本地控制、可离线运行或避免每次请求暴露给模型提供方很重要,且硬件与运维成本可接受时,它是一个合适选择。
结论
对能满足当前硬件要求的构建者,Edge0 是资料完整且仍在积极维护的本地模型选项。应把 145B/120B 当成聚焦 NVIDIA 的部署路线,先在自身工作负载验证,并以官方仓库作为快速变化的安装细节来源。
评论
还没有评论。成为第一个评论的人!
相关工具


相关洞察
用 magpie 把 Codex 接到任意模型
安装 magpie,加入本地或已登录的供应商,再把 Codex 切到该模型。2026-10-06 对照 magpie 官方文档复核。

按仓库任务选 AI 编程 CLI
按你真正要跑的工作,在 Claude Code、Codex CLI、OpenCode、Pi、omp、DeepSeek Harness 与 Grok Build 之间选择。2026-10-06 对照官方文档复核。
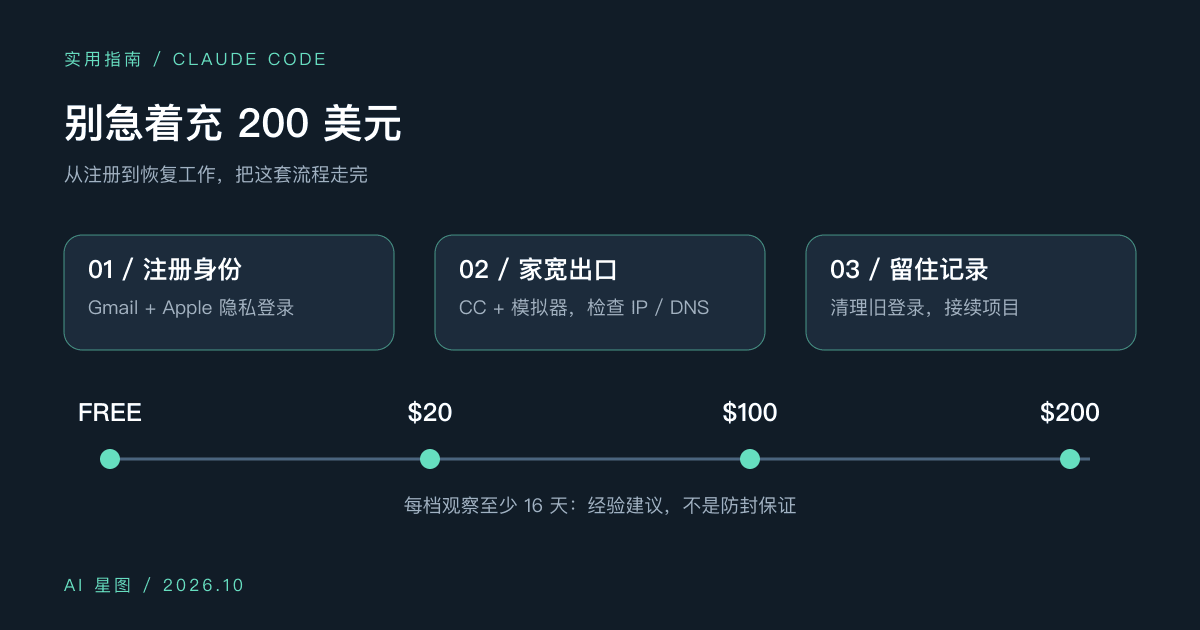
Claude Code 使用秘籍:别急着充 200 美元,先走完这套流程
Gmail 配 Apple 隐私登录,Clash Verge 接 Cliproxy 家宽,模拟器也查 IP 和 DNS。订阅每档隔半个月以上,账号出问题先保住 CC 记录。附配置和脚本。