
2026 年 AI 模型怎么比
这里的模型页是产品卡片,不是我们编的榜单。写代码和智能体仍是 GPT 与 Claude。Gemini 是 Google 体系默认。Grok 是 xAI。DeepSeek 是真正会被人私有化部署的开源权重。打开词条看现行模型 ID 和厂商价目,不要把目录简介当成评测。
写代码用哪个模型?
每个季度都会变。去 Claude、GPT、Gemini 的官网,再用你自己的仓库跑一遍。本页不冻结排行榜。
开源权重还是 API?
API 简单。DeepSeek、Llama、Qwen、Gemma 适合要自己跑的场景。成本是机器和运维,不是一张 $20 订阅。
价格在哪看?
只看厂商。OpenAI、Anthropic、Google、xAI、DeepSeek 各自公布。我们给链接,不编造 token 单价。
2026 年 AI 模型怎么比全部工具(共 211 款)
点击查看每款工具的详情、功能与定价。
 Agnes-3.0-FlashAgnes-3.0-Flash Preview 是 Apache-2.0 的 33B 多模态开源权重,上下文 262k,…
 Claude 3.5 Sonnet上一代 Claude 3.5 Sonnet 快照。活文档主推 Claude 5 / 4.6。不是 2026 默认聊天模型…
- Claude 3 Haiku上一代 Claude 3 Haiku 快照。活文档主推 Claude 5 / 4.6。不是 2026 默认高速模型。
- Claude 3 Opus上一代 Claude 3 Opus 快照。活文档现在主推 Claude 5 / 4.6。不是 2026 默认旗舰。
- Claude 3 Sonnet上一代 Claude 3 Sonnet 快照。活文档主推 Claude 5 / 4.6。不是 2026 默认企业模型。
- Claude Opus 4.5Anthropic 上一档 Opus 快照:20 万上下文,每百万 token $5/$25。更晚在售的线包括 Opus…
- Claude Sonnet 4.5Anthropic 上一档 Sonnet 快照:20 万上下文,每百万 token $3/$15。文档现主推更新的 Cl…
- Claude v1上一代 Claude v1 快照。活文档主推 Fable 5 / Opus 5 / Sonnet 5 / Haiku 4…
 LensVLM-9B苹果发布的 9B 视觉语言模型:把文档当作压缩图片来读,只把真正相关的页面放大还原,在 4.3 倍压缩下仍保持全文级别的…
 AREX-2北京智源研究院 27B 开源权重智能体模型:在编码、机器学习工程与深度研究任务中迭代改进方案,支持 262K 上下文。
 Bespoke NimbleBespoke Labs 开源的 9B 权重模型与完整训练配方,把 Jev 式的判定变成带概率的单 token 选择,可…
 BGE-M32024 年 BAAI 多语言嵌入模型快照。MIT 卡仍在。不是 2026 年 MIRACL 或 MTEB 王冠。
 BAAI bge-reranker-v2.5-gemma2-lightweight上一代 BGE reranker v2.5 Gemma2 lightweight 快照。
 Breeze TTS 2BreezeBlue 开源的双语语音合成模型,专为实时交互而生。支持免参考音色的语音设计、参考引导的音色指挥,冷启动首音…
- Claude Fable 5.1Anthropic 公开发布的 Fable 级模型,面向编程与知识工作。输入/输出 $10/$50 /百万 token,…
- Claude Fable 5Anthropic 首个向公众开放的 Mythos 级旗舰模型:1M token 上下文、前沿编程与视觉能力、长达数天的…
- Claude Haiku 4.5Claude Haiku 4.5:活文档上的便宜高速行,每百万 $1/$5、200k 上下文。
- Claude Mythos 5.1Anthropic 面向网络安全与生命科学的最强模型,需受邀可信访问。与 Claude Fable 5.1 同一引擎,但…
- Claude Opus 4.6Anthropic 最强混合推理模型:100 万 token 上下文、自适应思考,在智能体编码与专业知识工作上位居行业前…
- Claude Opus 5.5Anthropic Claude Opus 5.5:Fable 5.1 级智能,每 1M token $4/$20,1M…
- Claude Opus 5Anthropic 前沿 Opus 级模型,1M token 上下文与可调思考强度,以 Opus 4.8 的价格带来接近…
- Claude Sonnet 5.5Anthropic Claude Sonnet 5.5:Claude 5.5 家族第二款模型,价格与 Sonnet 5…
- Claude Sonnet 5Claude Sonnet 5:活文档上的中档 1M 上下文行,每百万 $2/$10。不是 leftover Sonne…
 cogvlm-base-490-hf上一代 CogVLM 快照。网站已从错误的 DeepSeek-VL 卡改回 CogVLM。不是 2026 VLM 默认。
 Cohere Command A+Command A+ 是 Cohere 首个混合专家旗舰:218B 总参数、25B 激活参数,支持 48 种语言与图像输…
- Cohere: Command ACohere Command A:一手文档上的活 Command 主推。2026-08-18 复核官方 Command…
- Cohere: Command R上一代 Cohere Command R 快照。活文档主推 Command A。不是 2026 对话或 RAG 默认。
- Cohere Embed v3上一代 Cohere 嵌入模型快照。活目录已经是 Embed 4。不是每百万 $0.10 的 2026 默认路径。
- Cohere Rerank 3.5上一代 Cohere 重排序模型快照。活文档现在主推 rerank-v4.0。不是每千次 $2 的 2026 普查。
 OpenAI: dall-e-2上一代 OpenAI DALL-E 2 快照。活图像路径是 GPT Image 2。DALL-E 3 已从 API 移除…
- OpenAI: dall-e-3OpenAI 2023 年 11 月的图像模型,现已弃用并从 API 移除。官方要求新项目改用 GPT Image 2。
 Deepgram Nova-2上一代 Deepgram 语音识别模型。官方文档先推荐 Nova-3 / Flux。不是 2026 年的最快皇冠。
 DeepSeek-Coder-V2.5上一代 DeepSeek 代码快照。活路径已经是 V4 Flash/Pro。不是 90.2% HumanEval 普查。
- DeepSeek-R1上一代 DeepSeek-R1 快照。活路径已经是 V4 Flash/Pro。不是 o1 / 2026 推理默认。
- DeepSeek V2.5上一代 DeepSeek V2.5 快照。活路径已经是 V4 Flash/Pro。不是 2026 聊天加编程默认。
- DeepSeek V3上一代 DeepSeek V3 快照。活路径已经是 V4 Flash/Pro。不是 GPT-4o / Claude 3.…
- DeepSeek-V4.1-FlashDeepSeek-V4.1-Flash 是 MIT 的 552B 多模态 MoE,预填充 8B、解码 16B 激活,1M…
 DeepSeek-V4-Flash-Vision-ExpDeepSeek-V4-Flash-Vision-Exp 是 V4 家族首个多模态实验:Flash 架构加视觉模块,MI…
- DeepSeek V4 FlashDeepSeek 官方小型智能体模型:284B 总参 / 13B 激活 MoE 架构、1M token 上下文、MIT…
- DeepSeek V4 Pro 0813DeepSeek 旗舰 1.6T MoE 模型,激活参数 49B,1M token 上下文,MIT 协议开源权重,Liv…
- DeepSeek V4DeepSeek V4 预计将是 DeepSeek 旗舰模型系列的下一个重大版本,继备受赞誉的 V3 和 V3.2 之后…
- deepseek-vl-7b-base上一代 DeepSeek-VL 7B Base 快照。活路径已经是 V4 Flash/Pro。不是 2026 默认视觉语…
 DFlash 2Inco AI 的 Apache 2.0 块扩散推测解码草稿模型。2026-08-18 发布,覆盖 Qwen3.8-27…
 ElevenLabs Turbo v2.5上一代 ElevenLabs Turbo v2.5 快照。活模型主推 v3 / Flash v2.5。不是 2026 默…
 EmbeddingGemmaGoogle DeepMind 的轻量级多语言文本嵌入模型,专为设备端 AI 优化,内存占用小于 200MB。Embed…
 Ember-1Fireworks Research 把 Kimi K3 改造成「想得更少」的版本:基准分数基本不变而 token 少约…
 Flux.1 Dev2024 年 BFL 开源权重静帧。
- Flux.1 Pro上一代 BFL 图像 SKU。活目录是 FLUX 3 和 FLUX.2。不是 2024 年压过 Midjourney/D…
 FLUX 3Black Forest Labs 多模态模型,覆盖视频、音频、即将推出的图像与动作预测,支持最长 20 秒片段、原生音…
 Gemini 2.0 Flash Thinking以往的 Gemini 2.0 Flash Thinking 快照。
- Gemma 4 26B A4BGoogle DeepMind 开源权重模型,25.2B 总参数 MoE 架构每 token 仅激活 3.8B,256K…
 GLM-4.7智谱 AI 推出的开源多语言多模态对话模型,具有先进的思考能力、卓越的编码性能和增强的 UI 生成能力。GLM-4.7…
- GLM-5.2智谱 2026 年 6 月的 744B MoE 编程模型,1M 上下文、MIT 权重。现行旗舰已是后继的 GLM-5.3…
- GLM-5.3-Flash智谱首个原生多模态 GLM 系列模型(即此前匿名的 'Ox Alpha'):320B MoE、仅 18B 激活、1M 上…
- GLM-5.3智谱编程模型,挂在 GLM Coding Plan。
- Google: Gemini 1.5 Flash-8B上一代 Gemini 1.5 Flash-8B 快照。活 API 主推 Gemini 3 Flash。不是 2026 默…
- Google: Gemini 2.0 Flash以往的 Gemini 2.0 Flash 快照。已弃用并在 2026-06-01 关停。活 Flash 是 Gemini…
- Google: Gemini 3.1 Flash-LiteGoogle Gemini 3.1 Flash-Lite:活模型页上的 leftover 便宜 Flash-Lite 兄…
- Google: Gemini 3.1 Flash LiveGoogle Gemini 3.1 Flash Live:活 Gemini 模型页上的 leftover 实时/音频兄弟…
- Google: Gemini 3.1 Flash TTSGoogle Gemini 3.1 Flash TTS:活 Gemini 模型页上的 leftover TTS 兄弟。2…
- Google: Gemini 3.1 ProGoogle Gemini 3.1 Pro:活模型页上的 leftover Pro 兄弟。2026-08-18 复核。不…
- Google: Gemini 3.5 Flash-LiteGoogle Gemini 3.5 Flash-Lite:活 Gemini 模型页上仍挂着的廉价 Flash-Lite…
- Google: Gemini 3.5 FlashGoogle 以行动为导向的前沿模型:为智能体与编码而生,支持 100 万 token 上下文,以 Flash 级别的速…
- Google: Gemini 3.5 Live TranslateGoogle Gemini 3.5 Live Translate:活 Gemini 模型页上的 leftover 实时翻…
- Google: Gemini 3.6 FlashGoogle Gemini 3.6 Flash:3.5 之后、活 3.7 Flash 之前的上一代 Flash。2026…
- Google: Gemini 3.7 FlashGoogle 面向智能体工作流与多模态推理的最强 Flash 模型:100 万 token 上下文、6.5 万输出 to…
- Google: Gemini 3.8 Flash TTSGemini 3.8 Flash TTS 能用一句话设计全新音色、30 秒样本复刻嗓音,并以 71.4 分拿下 Hume…
- Google: Gemini 3 FlashGoogle 最新前沿模型,以前所未有的速度和成本效益提供突破性智能。Google: Gemini 3 Flash 收录…
- Google: Gemini 3 Pro上一代 Gemini 3 Pro Preview 快照。官方模型索引已标关停。不是 2026 视觉王冠,也不是当前默认。
- Google: Gemini 4 ArgonGoogle 新一代前沿模型:面向长时程编程、企业知识工作与网络防御,输出上限提升至 100 万 token,并经由 F…
- Google: Gemini Flash 1.5上一代 Gemini 1.5 Flash 快照。活 API 主推 Gemini 3 Flash。不是 2026 默认多模…
- Google: Gemini Nano Banana 2 LiteGoogle Gemini Nano Banana 2 Lite:活 Gemini 图像页上的 leftover 更便宜…
- Google: Gemini Omni FlashGoogle Gemini Omni Flash:活 Gemini 模型页上的 leftover Omni Flash…
- Google: Gemini Pro 1.5上一代 Gemini 1.5 Pro 快照。活 API 主推 Gemini 3 Pro。不是 2026 默认多模态。
- Google: Gemma 2 27B上一代 Gemma 2 27B 快照。活开源路径是 Gemma 4。不是 2026 默认开放模型,也不是 Gemini…
- Google: Gemma 2 9B上一代 Gemma 2 9B 快照。活开源路径已经是 Gemma 4。不是 2026 默认小模型,也不是效率新标准。
- GPT-5.6 LunaOpenAI GPT-5.6 Luna:5.6 家族快速实惠档,12.8 万上下文,每 100 万 tokens 输入…
- GPT-5.6 TerraOpenAI GPT-5.6 Terra:5.6 家族均衡日常主力,40 万上下文,每 100 万 tokens 输入…
- GPT-5.2OpenAI 上一世代前沿模型:40 万上下文、12.8 万最大输出,每百万 token $1.75/$14。文档现推荐…
- GPT-5.6 SolOpenAI 前沿旗舰:1,050K token 上下文、最高 max 档推理强度与 ultra 子智能体模式,Term…
- GPT-6.1 SolOpenAI GPT-6.1 Sol:面向编程、电脑操作和专业工作的近 Astra 级智能,标准 API 价格为 GPT…
- GPT-6 AstraOpenAI 旗舰 GPT-6 Astra:105 万 token 上下文,电脑操作与编程达新高,API 每 1M to…
- GPT-6 LunaOpenAI GPT-6 Luna:GPT-6 系列最便宜的档位,每 1M token $0.10/$0.50,105…
- GPT-6 SolOpenAI GPT-6 Sol:105 万 token 上下文、推理强度可拉到 max,每 1M token $2/$…
 GPT Image 2OpenAI 最新图像生成模型,面向快速、高质量的生成与编辑,支持灵活尺寸至 4K,并按 token 计费的官方 API…
 IBM Granite 4.2 30BIBM 的开源权重稠密推理大模型:30B 参数、Apache 2.0、原生 128K 上下文可扩至 512K,内置思维链…
 Grok 4.6SpaceXAI(原 xAI)的前沿 1.5T 推理模型,具备 50 万 token 上下文、出色的智能体编码能力与实时…
- Grok 4.7SpaceXAI 的 Grok 4.7 旗舰,面向编码与智能体:50 万 token 上下文,$1.60/$4.80 每…
- GrokxAI / SpaceXAI 的 Grok 家族。当前文档旗舰是 grok-4.6:50 万上下文、$2/$6 每百万…
 Hy4 preview腾讯新一代开源权重 MoE 旗舰:总计 770B、每 token 激活 49B,1M 上下文,Apache 2.0。采用…
 Ideogram 2.0Ideogram 2.0 是 2024 年 8 月快照。不能当成已证实的当前默认模型,也不编造后续版本号或席位表。
 Index-Translate哔哩哔哩开源的多语言翻译模型家族:覆盖 150 种语言文本、语音字幕、受控配音与长文档翻译,基于 Qwen3.5 构建。
 JevJev 是 TypeSafe 的 System One 模型,输出带校准概率的类型化决策,输入价为每百万 token 0…
 Jina Embeddings v4上一代 Jina Embeddings v4 快照。leftover 2025 年 6 月卡。旧的 3.8B / 819…
- Jina AI Reranker v3上一代 Jina 重排模型快照。活页主推 reranker-v3.5。不是 8192/BEIR 的 2026 普查。
 K2-Horizon-7BK2-Horizon-7B 是 IFM 推出的开放权重语言模型,提供 512K 上下文、工具调用与分阶段训练检查点,适合…
 KAT-Coder V2.5Kwaipilot 开源智能体编程模型:35B MoE、每 token 激活 3B,基于 Qwen3.6 基座,Apac…
 Kimi K3月之暗面(Moonshot AI)开源的 2.8T 参数多模态智能体模型,1M token 上下文,全球首个开源 3T…
 Kolibri-1Aleph Alpha 发布的德英双语开放权重推理模型,总参数约 78B、每 token 激活约 3.46B,支持工具调…
 Laguna S 2.1Poolside 开源权重编程模型:118B 总参 / 8B 激活 MoE、100 万 token 上下文、原生交错推理…
 LFM 2.5-2.6BLiquid AI 专为端侧智能体负载训练的 2.6B 开源权重稠密模型,支持 128K 上下文与原生工具调用。LFM…
 Ling-3.0-flash-VLLing-3.0-flash-VL 是 inclusionAI 的 MIT 多模态 MoE:总参 124B,激活 5.5…
 Ling-3.0-flashinclusionAI 的 MIT 混合线性 MoE:总参 124B,激活 5.1B。2026-08-21 在 Hugg…
 Ling-3.0-tinyLing-3.0-tiny 是 inclusionAI 的 MIT 混合线性 MoE:总参 7.9B,激活 1.3B,面…
 Llama 3.1 Euryale 70B v2.2上一代 Llama 3.1 Euryale 70B v2.2 快照。leftover Sao10k 角色扮演卡。不是 2…
- Llama 3 Euryale 70B v2.1上一代 Llama 3 Euryale 70B v2.1 快照。leftover Sao10k 角色扮演卡。不是 202…
 LLaMA Guard 3上一代 Llama Guard 快照。活卡已经是 Llama Guard 4 12B。不是 2026 默认安全模型。
- llava-v1.6-34b-hf上一代 LLaVA-NeXT / LLaVA 1.6 快照。
 LongCat 2.0美团开源 MoE 大模型:总参数 1.6T / 激活约 48B,1M 上下文,MIT 协议,擅长编码与智能体任务(202…
 Mercury 2.5Inception 的扩散语言模型:260K 上下文,并行生成 1,107 tokens/s,首发期输入仅 $0.04/…
 Mercury 2Inception 的扩散推理模型:128K 上下文、并行生成约每秒 1000 token,输入价格每百万 token…
- CodeLlama 34B Instruct上一代 Code Llama 34B Instruct 快照。llama.com 现在主推 Llama 4 / Muse…
- Llama 3.1 405B Instruct上一代 Llama 3.1 405B Instruct 快照。llama.com 现在主推 Llama 4。不是 GPT…
- Llama 3.1 70B Instruct上一代 Llama 3.1 70B Instruct 快照。llama.com 现在主推 Llama 4。不是 2026…
- Llama 3.1 8B Instruct上一代 Llama 3.1 8B Instruct 快照。llama.com 现在主推 Llama 4。不是 2026…
- Llama 3.2 1B Instruct上一代 Llama 3.2 1B Instruct 快照。llama.com 现在主推 Muse。不是 leftover…
- Meta Llama 3.2 Vision2024 年 Llama 3.2 视觉快照。llama.com 现在主推 Llama 4。不是 2026 默认多模态。
- Llama 3 70B Instruct上一代 Llama 3 70B Instruct 快照。llama.com 现在主推 Muse。不是 2026 默认模型…
- Llama 3 8B Instruct上一代 Llama 3 8B Instruct 快照。llama.com 现在主推 Muse。不是 2026 默认模型。
- Llama v2 70B Chat上一代 Llama v2 70B Chat 快照。llama.com 现在主推 Llama 4 / Muse。不是 20…
 Midjourney V6Midjourney V6 是 2023 年 12 月快照。后续版本已经在。不是当前默认模型,也不编造席位价格表。
 MiMo-V2.6小米 MiMo-V2.6 开源权重系列:旗舰 Pro 为 1.02T 总参数、42B 激活的稀疏 MoE,另有 309B…
 mini-AGImini-AGI 是一个字节级模型,在 8GB 显存显卡上从零开始训练,并能持续从单一数据流中学习而不遗忘已掌握的内容。
 MiniCPM5-2B面壁智能 MiniCPM5-2B 是 2B 端侧稠密模型,131k 上下文、Apache-2.0 开源,面向本地助手与工…
 MiniMax H3MiniMax 于 2026 年 7 月 31 日发布的开源向多模态视频模型:文/图/视频/音频输入,768P 或 2K…
 MiniMax M2.1开源的 230B 参数 MoE 模型,专为多语言编程、智能体工作流和真实世界开发任务优化,SWE-bench 性能达到…
 MiniMax M3MiniMax 2026 年 6 月 1 日的开源向旗舰模型:MSA 架构、100 万 token 上下文、原生图像/视…
- MiniMax-Music3MiniMax 第三代开源权重音乐生成模型:录音棚级音质与无数码杂音的自然人声,凭提示词和歌词生成完整歌曲,官方支持 C…
 Mistral: Mistral 7B Instruct上一代 Mistral 7B Instruct 快照。活目录是 Medium 3.5 / Small 4 / Large…
- Mistral: Mistral Nemo以往的 Mistral Nemo 12B 快照。旧 NVIDIA 128k 路径。活目录是 Medium 3.5 / S…
- Mistral Nemo Inferor 12B上一代 Inferor 12B 快照。
- Mistral OCR 4.1Mistral OCR 4.1:活目录上的最新 OCR,带段落框、结构标签与置信度。每 1000 页 $4,不是 lef…
- Mistral Pixtral 12B2024 年 Mistral 12B 视觉快照。活目录是 Medium 3.5 / Small 4 / Large 3。…
- Mistral Shieldstral 1.0Mistral Shieldstral 1.0:活目录上的紧凑多模态审核模型。2026-08-18 复核。Apache…
- Mistral Small上一代 Mistral Small v24.09 快照。活目录是 Medium 3.5 / Small 4 / Larg…
- Mistral Tiny以往的 Mistral Tiny 快照。旧 7B-v0.2 路径。活目录是 Medium 3.5 / Small 4 /…
- Mistral Voxtral Mini Transcribe 2Mistral Voxtral Mini Transcribe 2:活 Premier 转写行,v 26.02。
- Mistral Voxtral Mini Transcribe RealtimeMistral Voxtral Mini Transcribe Realtime:活实时转写兄弟。2026-08-18…
- Mistral Voxtral TTSMistral Voxtral TTS:活目录 TTS 行,v 26.03,CC BY-NC 4.0。2026-08-1…
 Muse GlimmerMeta 开源 30B 智能体多模态模型:从 Muse Spark 蒸馏,专为本地常驻编码与工具调用智能体设计,单张消费…
- Muse Spark 1.2Meta 面向编码的旗舰模型,驱动 Muse Code 终端智能体:1M 上下文、更高的首试准确率、可靠的工具调用,通过…
 mixedbread ai mxbai-rerank-large-v1上一代 mxbai-rerank-large-v1 快照。
 MythoMax 13B上一代 MythoMax 13B 快照。leftover Llama 2 微调卡,不是 2026 前沿默认。旧的最高性能…
 Nex-N2.5-miniNex-N2.5-mini 是 Nex-AGI 的 Apache-2.0 多模态智能体模型,面向计算机使用、浏览和编程。
 Nex-N2.5-ProNex-N2.5-Pro 是 Nex-AGI 的 Apache-2.0 多模态智能体检查点,面向计算机使用、浏览和编程。
 Nous: Hermes 3 405B Instruct上一代 Hermes 3 405B Instruct 快照。leftover Llama 3.1 405B 微调卡。不是…
- NousResearch: Hermes 2 Pro - Llama-3 8B上一代 Hermes 2 Pro Llama-3 8B 快照。leftover HF 卡,不是 2026 默认。旧的升级…
 NV-Embed-v22024 年 NVIDIA 嵌入模型快照。Hugging Face 卡仍在。不是 2026 年 MTEB 第一名普查。
- NVIDIA nv-rerankqa-mistral-4b-v3上一代 NVIDIA nv-rerankqa-mistral-4b-v3 快照。
- NVIDIA: Llama 3.1 Nemotron 70B Instruct上一代 NVIDIA Llama 3.1 Nemotron 70B Instruct 快照。
- NVIDIA Nemotron 3.5 Lightning 30B A3BNVIDIA 高效开源权重模型,30B 总参数仅激活 3B,MoE 混合架构,最长 1M token 上下文,单卡部署,…
- omni-moderation-latestOpenAI 托管的 omni-moderation 内容审核快照。文档仍列出该别名。不是 2026 默认安全路径。
- OpenAI: GPT-4o-mini以往的 GPT-4o mini 快照。仍挂牌 $0.15/$0.60;活起点是 GPT-5.6 Sol。不是 2026…
- OpenAI: GPT-4o以往的 GPT-4o 全能快照。仍挂牌 $2.50/$10;活起点是 GPT-5.6 Sol。不是 2026 最新。
- OpenAI: o1-mini以往的 OpenAI o1-mini 廉价推理快照。仍是 $1.10/$4.40;过期孪生已弃用。不是 2026 推理默…
- OpenAI: o1-preview以往的 o1-preview 快照。仍是 $15/$60;过期孪生已弃用。不是更便宜的 o1,也不是 2026 默认。
- Shap-e上一代 OpenAI Shap-E 快照。leftover 2023 三维研究卡,不是 2026 图像/三维默认。活静帧…
 OpenChat 3.5 7B上一代 OpenChat 3.5 7B 快照。leftover C-RLFT 卡,不是 2026 前沿默认。旧的最新开源…
 OrukeetOrukeet 是覆盖 25 种语言的语音识别模型,在 NVIDIA Parakeet TDT 0.6B v3 上冻结拟…
 Peacebell从零训练的英语二战主题小模型,提供 291M 与 148M 参数版本、Apache-2.0 权重及 CPU 演示,不具备…
 Qwen 4阿里下一代旗舰 Qwen 4 正在训练中,官方路线图显示 Qwen 4.5 与 Qwen 5 系列预计将扩展到 5 万亿…
- Qwen-Audio-3.1阿里 Qwen-Audio-3.1 语音栈新增 ASR-Next 与 TTS-Next,TTS 登顶 Artificia…
 Qwen-Drive-1.0-4BQwen-Drive-1.0-4B 是阿里 Apache-2.0 的驾驶视觉语言模型,把三维感知、VQA 和运动规划放在…
 Qwen-Image-2.1Qwen-Image-2.1 是阿里 7B 开放权重模型,同一套权重既做文生图也做图像编辑,还支持原生透明 PNG 与最…
- Qwen-VL上一代阿里 Qwen-VL 快照。活旗舰已经是 Qwen3.8。不是 2026 默认大规模视觉语言模型,也不是当前 LV…
- Qwen2.5 72B Instruct上一代 Qwen2.5 72B Instruct 快照。活旗舰已经是 Qwen3.8。不是 2026 年最新系列。
- Qwen2.5-72B上一代通义千问稠密大模型。活旗舰已经是 Qwen3.8。不是 2026 年压过 Llama-3-405B 的皇冠。
- Qwen2.5 Coder 32B Instruct上一代 Qwen2.5-Coder 32B Instruct 快照。活编码路径是 Qwen3.8 Coder。不是最新系…
- Qwen2.5-Coder-32B上一代通义代码专用模型快照。活编程路径已经是 Qwen3.8 Coder。不是 85% HumanEval 普查。
- Qwen2-VL 72B Instruct上一代 Qwen2-VL 72B Instruct 快照。活路径已经是 Qwen3.8。不是 2024 视觉语言王冠。
- Qwen3.8-2.4T-A95B阿里巴巴旗舰 2.4T MoE 模型,激活参数 95B,1M token 上下文,原生多模态输入,PaperBench…
- Qwen3.8-27B阿里巴巴开源的 27B 稠密模型,Qwen3.8-Max 的配套稠密版本,Apache 2.0 协议,支持图文多模态输入…
- Qwen3.8-Flash-Next阿里通义千问公开的 Qwen4 架构预览:125B 多模态 MoE、每 token 仅激活 6B,外加 51B N-gr…
- Qwen3.8-Max阿里 2.4T 参数开源旗舰:95B 激活的 MoE,原生文本/图片/视频输入,1M 上下文,输入 $2 / 输出 $6…
- Qwen3.8-Omni-FlashQwen3.8-Omni-Flash 是阿里的全模态智能体模型:100 万 token 上下文,原生输入文本、图像、音频…
- Qwen3-Embedding上一代 Qwen3 嵌入快照。Hugging Face 仍列出该系列。旧的 MTEB 第一和 70.58 不当 2026…
- Qwen3-VL-Embedding上一代 Qwen3-VL 嵌入快照。Hugging Face 仍列出 2B / 8B。旧的最新多模态嵌入王冠不当普查。
- Qwen3-VL-Reranker上一代 Qwen3-VL 重排序快照。Hugging Face 仍列出 2B / 8B。旧的前沿多模态重排序王冠不当普查…
- QwQ-32B-Preview上一代 QwQ-32B-Preview 快照。leftover 2024 年 11 月推理器。旧的 o1-preview…
 Realtime-VenusRealtime-Venus 是 Apache 2.0 的 9B 全双工音视频模型,能在继续听的同时说话、被打断、并委派…
- rerank-english-v3.0上一代 Cohere 英文重排序快照。活文档主推 rerank-v4.0。旧的 4096 / 当前英文王冠不当普查。
- rerank-multilingual-v3.0上一代 Cohere 多语言重排序快照。活文档主推 rerank-v4.0。旧的 4096 / 当前非英文王冠不当普查。
- Cohere: rerank-v3.5上一代 Cohere rerank-v3.5 快照。活文档主推 rerank-v4.0。旧的 SoTA / 4096 王…
 Rocinante 12B上一代 Rocinante 12B 快照。leftover TheDrummer 叙事卡,不是 2026 前沿默认。旧的…
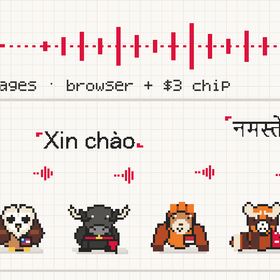 sanoTTS超小神经网络 TTS,参数量 294k 到 2.3M。可在浏览器或约 3 美元的 ESP32-S3 上离线合成。11 个…
 Seedance 2.5ByteDance Seed 的音画联合生成模型,面向 30 秒叙事、更准的参考控制、可延长两次,并提供绿幕等专业剪辑能…
 Upstage: Solar Mini 4Upstage 的 35B 混合专家模型,仅 3B 激活参数,512K 上下文,输入 $0.10/百万 token,主打…
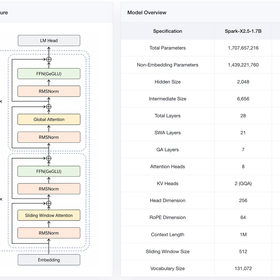 Spark-X2.5-4BXHToken 出品的精简开源权重模型:混合滑窗注意力实现原生 1M 上下文,编码与 Agent 表现出色,Apache…
 Stable Diffusion 3.5Stable Diffusion 3.5 是 2024 静帧家族。社区许可,不是完全 MIT。首页还主推音频和 Bran…
 StepAudio 3 GenStepAudio 3 Gen 是阶跃星辰的音频生成模型,可根据角色、台词和场景描述组合生成配音、音效、环境音与音乐,适…
 Supra2-IMGSupra2-IMG 是 Apache-2.0 许可的 104M 参数文生图 DiT,在一张 H100 上从零训练 9…
 Swift-Qwen3.8-27BSwift-Qwen3.8-27B 是 UkisAI 基于 Qwen3.8-27B 的高效推理微调,思考 token 约…
 Ternary Bonsai 2Ternary Bonsai 2 是 27B 的 Qwen3.8 三值 GGUF,模型卡称在 5.95 GB 包里保住…
- text-embedding-3-large2024 年 OpenAI embedding 快照。仍在目录。不是 2026 旗舰或 MIRACL 普查。
- text-embedding-3-small上一代 OpenAI 嵌入快照。定价页仍列每百万 $0.020。不是 2026 嵌入王冠,也不当最新里程碑或 23% 提…
- text-embedding-ada-002上一代 OpenAI 文本嵌入模型快照。价表仍列每百万 token $0.100。不是 2026 年默认嵌入路径。
- text-moderation-latest上一代 OpenAI text-moderation 快照。这是旧的纯文本审核路径。不是 2026 默认安全模型。
 Tiel-Coder 35B A3B智能体编码 MoE。
- OpenAI: tts-1-hdOpenAI 托管的 tts-1-hd 文本转语音快照。价表仍列每百万字符 $30。不是 2026 年默认语音路径。
- OpenAI: tts-1OpenAI 托管的 tts-1 文本转语音快照。价表仍列每百万字符 $15。不是 2026 年默认语音合成路径。
 VonVon 是 Apache-2.0 的 395M System One 决策模型,在 Apple MPS 上约 18 毫秒…
 voyage-3-largevoyage-3-large 是 Voyage AI 于 2025 年 1 月最新发布的最先进通用和多语言 embedd…
 Voyage AI Rerank 2上一代 Voyage 重排序模型快照。活文档主推 rerank-2.5。不是 16k/NDCG 的 2026 普查。
 WeLM-617B微信 AI 的 617B MoE 模型,每 token 激活 23B,通过 Hidden Decoding 首次在前沿规…
 WeMM-Embedding腾讯微信视觉团队推出的通用多模态嵌入模型家族(2B/4B/9B),基于 Qwen3.5。文本、图像、视频与视觉文档统一映…
- OpenAI: whisper-1OpenAI 托管的 whisper-1 语音快照。价表仍列每分钟 $0.006。不是 2026 默认语音转写路径。
- Whisper V3开源权重 Whisper large-v3 家族。
 WizardLM-2 7B上一代 WizardLM-2 7B 快照。不是 Microsoft 2026 默认。旧的比 10 倍更大开源模型相当不当…
- WizardLM-2 8x22B上一代 WizardLM-2 8x22B 快照。不是 Microsoft 2026 默认。旧的最先进 / 开源 SoTA…
- xAI: Grok Beta上一代 xAI Grok Beta 快照。活文档主推 grok-4.6。不是 2026 推理默认,也不是 Grok 2…
 YuE2-3BYuE2-3B 是 M·A·P 的 CC BY-NC 音乐模型,先写出可编辑乐谱,再渲染人声与伴奏,可在本地 24GB…